Au cours de l'année 2026, le mot harnessHarnessL'infrastructure qui entoure le modèle et en fait un agent : boucle, outils, contexte, permissions et traces s'est invité dans toutes les conversations sur les agents d'IAAgents d'IASystèmes exécutant des tâches multi-étapes sans supervision constante. On parle du « harness de Claude Code », de « changer de harness » ou du fait que « le harness importe plus que le modèle ». Une discipline à part entière a même vu le jour, la harness engineering, dont la paternité est disputée entre un article de Mitchell Hashimoto de février 2026 et un autre de LangChain en mars. Cela ressemble à un terme fraîchement inventé, mais ce n'est pas le cas : les électriciens automobiles assemblent des harnesses depuis un siècle et les programmeurs en écrivent depuis des décennies. La seule nouveauté réside dans le domaine d'application.
Qu'est-ce qu'un harness, en une phrase
La définition la plus claire est celle utilisée par Anthropic dans son guide d'évaluation des agents : « un harness d'agent (ou scaffold) est le système qui permet à un modèle d'agir en tant qu'agent : il traite les entrées, orchestre les appels aux outils et renvoie les résultats ». En résumé : c'est tout ce qui entoure le modèle pour qu'il puisse fonctionner. La boucle qui décide quand le solliciter à nouveau, les outils qu'il peut utiliser, le contexte qui lui parvient à chaque étape, les permissions qui le limitent et les traces qui enregistrent ses actions.
LangChain le résume par une équation devenue populaire cette année : agent = modèle + harness. Un modèle brut n'est pas un agent ; il le devient lorsqu'un harnais lui confère un état, l'exécution d'outils, des boucles de rétroaction et des limites applicables.
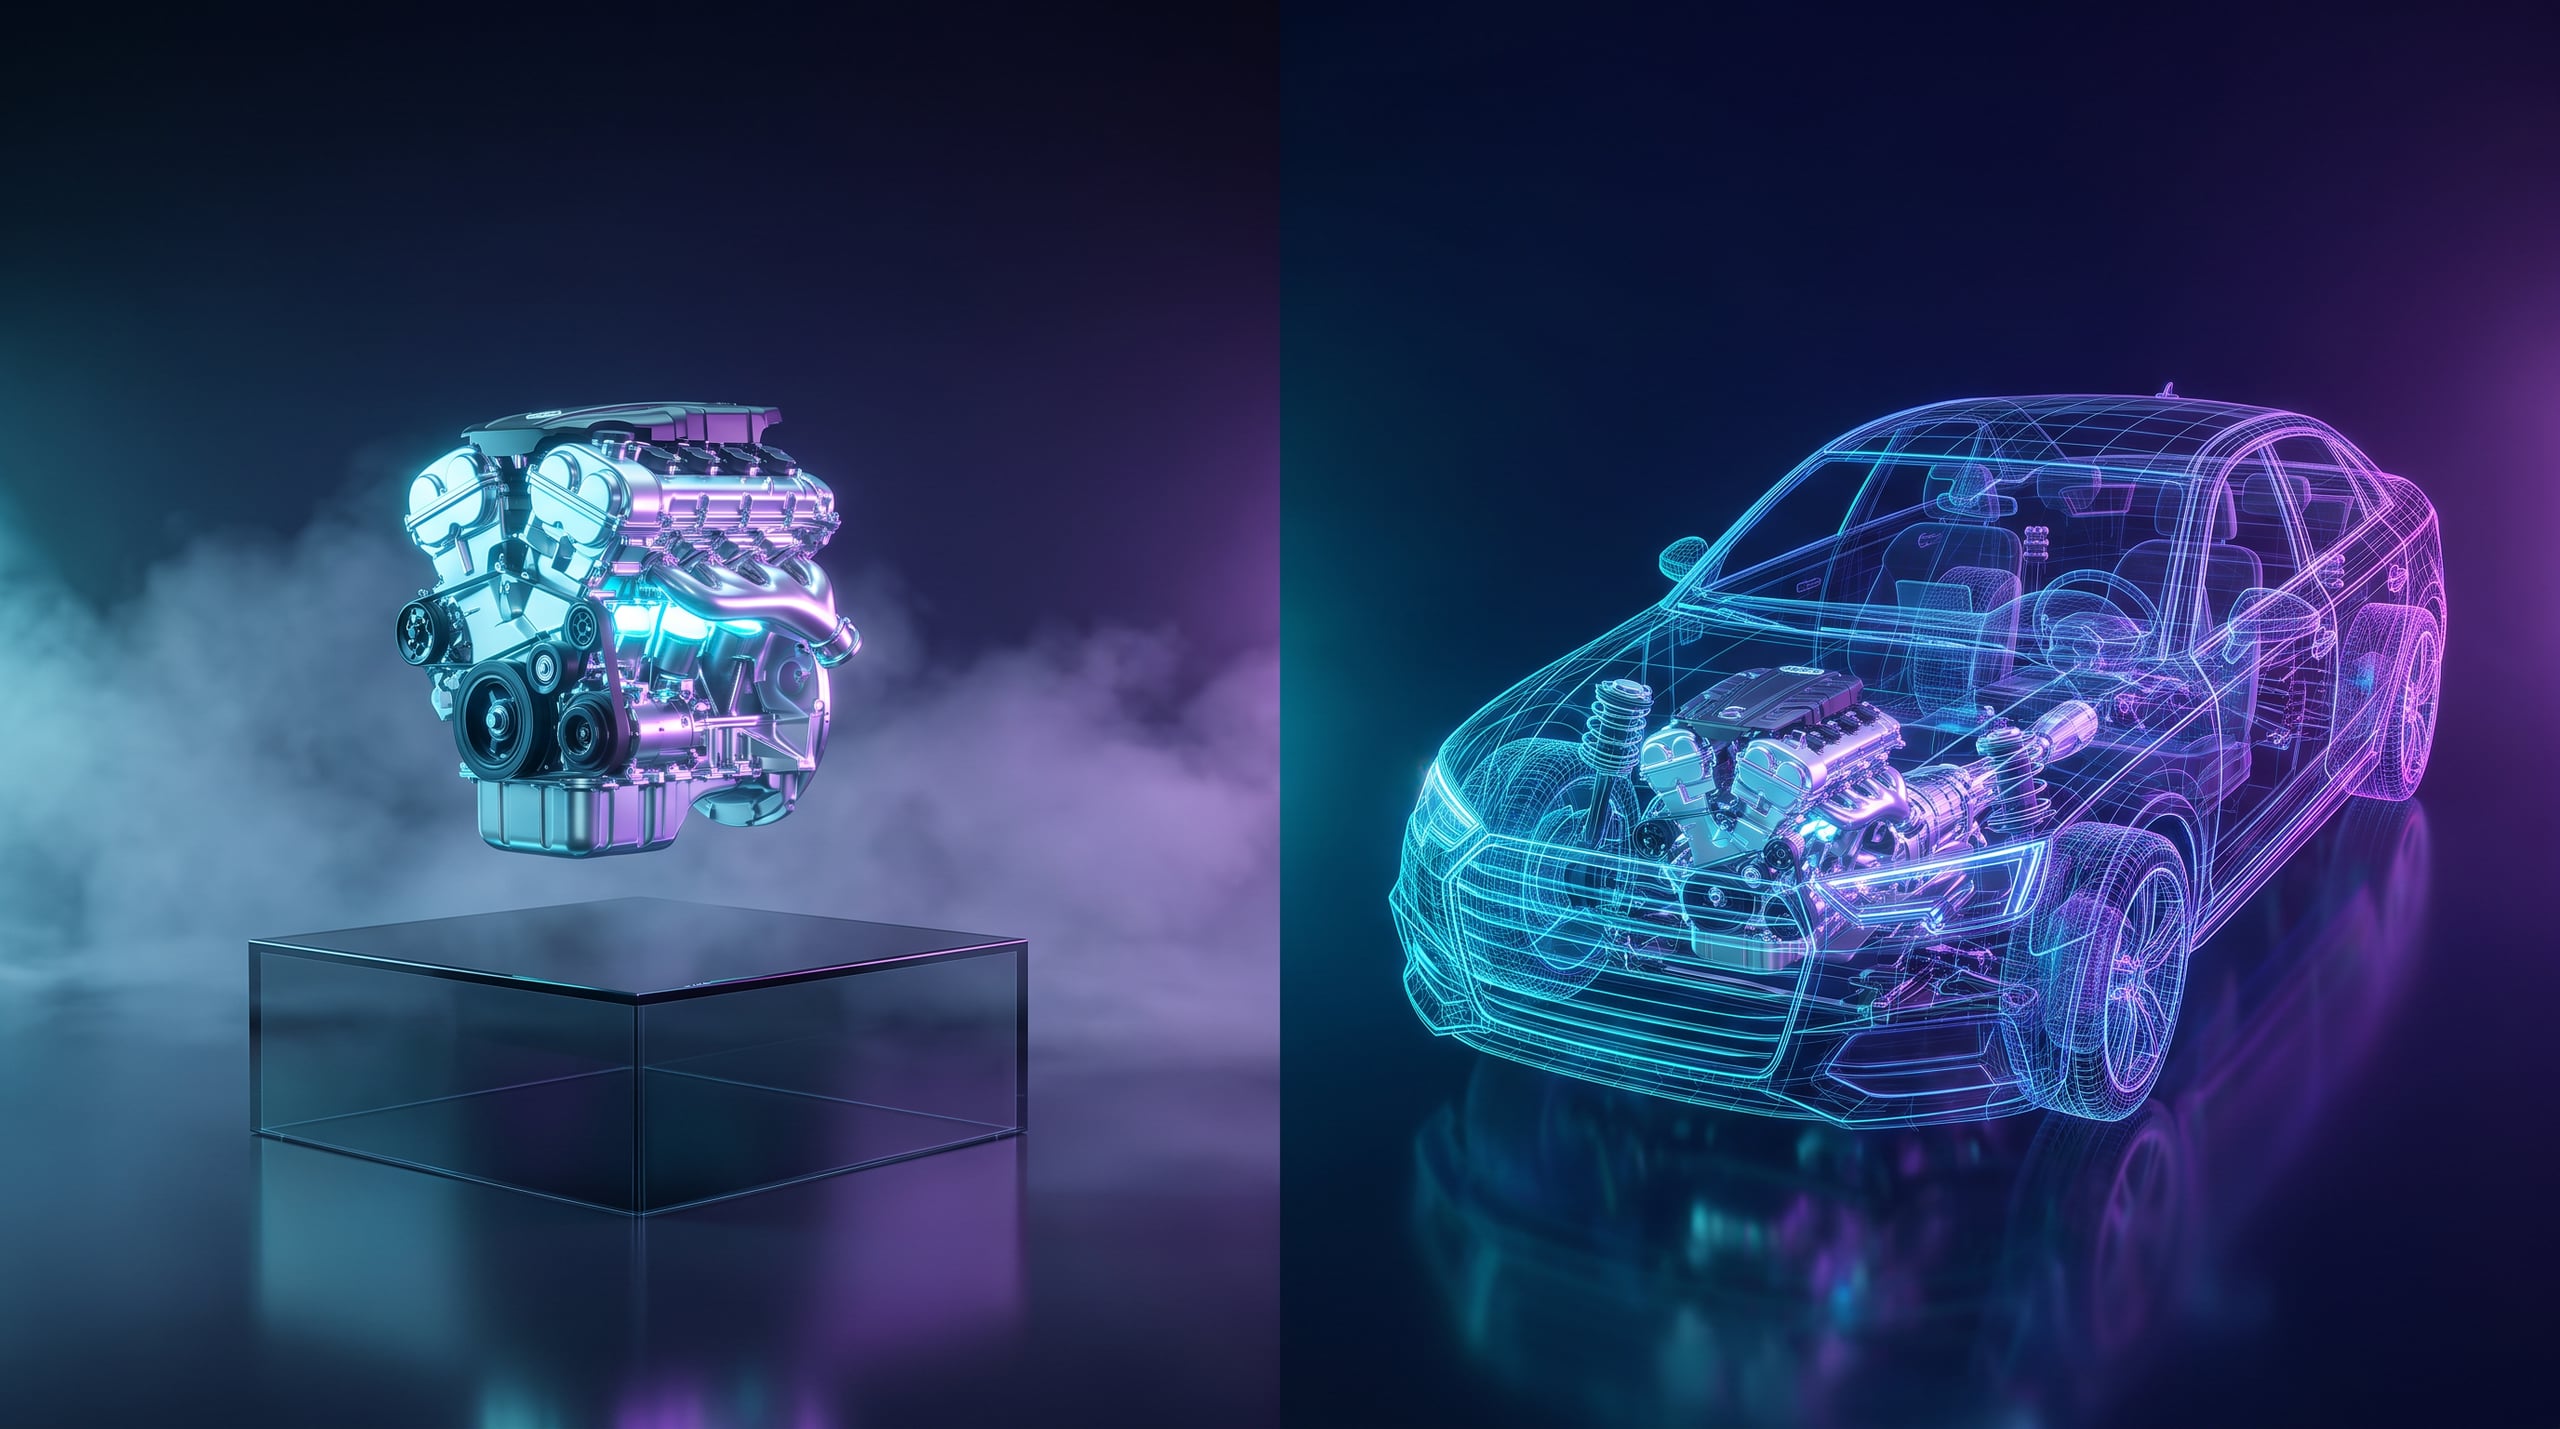
L'image qui l'explique le mieux : le modèle est le moteur et le harness est le reste de la voiture. Châssis, transmission, freins, direction, tableau de bord. Un excellent moteur sur une table ne vous mène nulle part, et le même moteur offre des performances très différentes selon le véhicule dans lequel il est monté.
D'où vient le nom
Harness signifie harnais : les sangles qui maintiennent un animal de trait, ou l'équipement qui empêche la chute de celui qui travaille en hauteur. L'ingénierie s'était déjà approprié le mot à deux reprises avant qu'il n'arrive dans l'intelligence artificielle.
Le faisceau de câbles
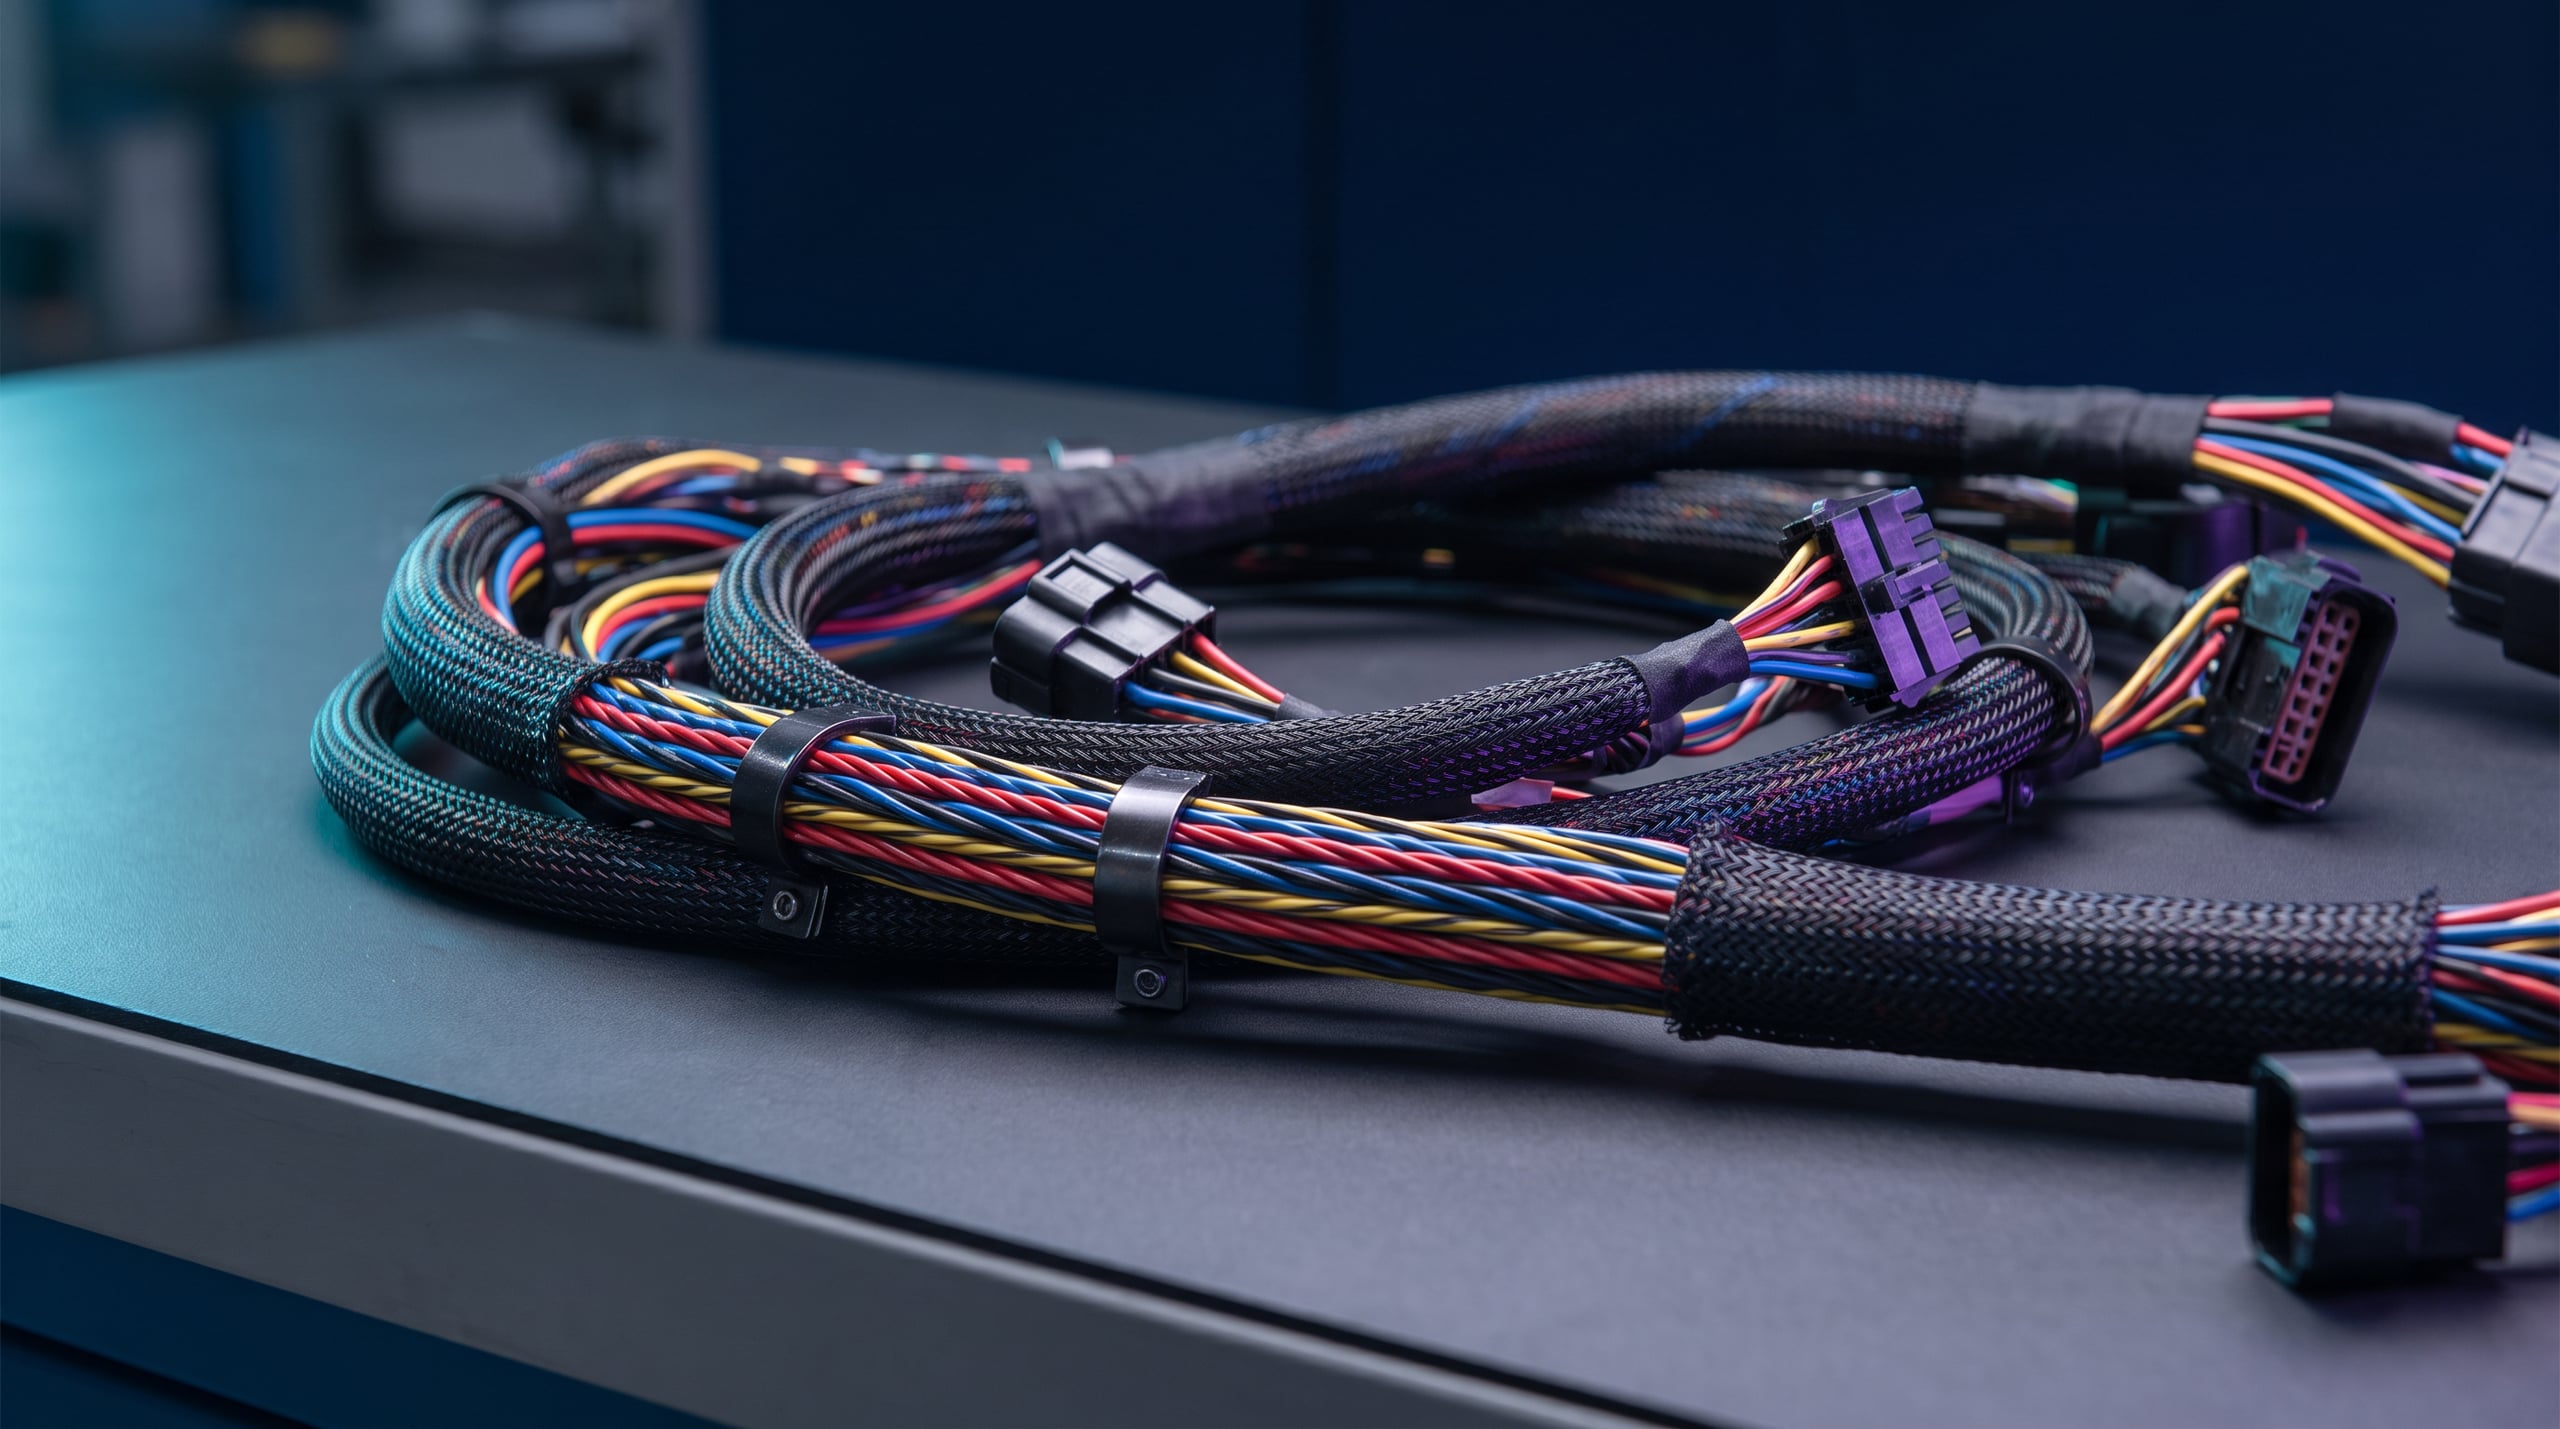
Dans l'automobile et l'aviation, un wiring harness est le faisceau de câbles qui parcourt le véhicule et relie le moteur au tableau de bord, aux feux, aux capteurs et au calculateur : des câbles regroupés et attachés dans une gaine résistante, terminés par des connecteurs. Il s'est répandu dans l'industrie automobile dans les années vingt, lorsqu'il est devenu évident que les câbles épars ne survivaient pas aux vibrations, à l'abrasion et à l'humidité. Un avion moderne contient des faisceaux qui, déroulés, atteindraient plusieurs kilomètres.
Ce qui est intéressant pour notre analogie, c'est que le faisceau ne fait rien par lui-même : il relie, ordonne et protège ce qui existe déjà. Sans lui, aucune pièce ne dialogue avec les autres.
Le harnais de tests
En logiciel, un test harness est l'ensemble des stubs et des drivers qui entoure une partie du programme afin de pouvoir l'exécuter de manière contrôlée : il lui injecte des entrées, recueille les sorties, les compare aux résultats attendus et produit un rapport. C'est une infrastructure d'imitation qui permet d'automatiser les tests, et c'est un vocabulaire courant en ingénierie logicielle depuis des décennies.
C'est exactement la même idée que celle appliquée aujourd'hui aux agents : une structure externe qui maintient la pièce, l'alimente et observe ce qu'elle fait. Lorsque les modèles de langage ont commencé à utiliser des outils et à enchaîner des étapes, il fallait un nom pour le code qui les enveloppe. Le terme attendait dans le placard.
Deux sens qu'il convient de ne pas mélanger
- Harness d'exécution (agent harness) : l'environnement qui fait fonctionner l'agent en production. C'est le sens dominant, celui employé lorsque quelqu'un dit « le harness de Claude Code ». Microsoft en a même fait une nomenclature officielle de produit : dans sa documentation de septembre 2026, il définit le harness comme « l'échafaudage d'exécution qui transforme un modèle de langageLLM (Grand modèle de langage)Grand modèle de langage, la base des chatbots actuels en un agent capable de travailler ».
- Harness d'évaluation (evaluation harness) : l'échafaudage qui exécute une batterie de tests contre un modèle pour le mesurer de manière reproductible. C'est l'héritier direct du test harness classique.
Ce sont des cousins germains : dans les deux cas, il y a une structure externe qui maintient le modèle et observe son comportement. Et dans les deux cas, celui qui construit le harnais conditionne le résultat.
Pourquoi le harness décide du résultat
C'est la partie qui intéresse une entreprise, et en 2026, ce n'est plus une opinion mais une donnée factuelle.
Même modèle, harnais différent, autre résultat. En février 2026, LangChain a publié une expérience rigoureuse : ils ont figé le modèle (GPT-5.2-Codex) et ont travaillé uniquement sur le harness. Son score sur Terminal-Bench 2.0 est passé de 52,8 % à 66,5 %, soit près de quatorze points, bondissant de l'extérieur du top 30 au top 5 du classement. Leur propre résumé : « nous avons seulement changé le harness ». Ce qu'ils ont modifié, ce sont les boucles d'auto-vérification, l'injection de contexte de l'environnement, la détection de boucles infinies et l'analyse automatique de traces. Rien de tout cela n'est le modèle.
Les classements mesurent des binômes, pas des modèles. Une étude de septembre de 2026 a audité 254 soumissions au leaderboard de SWE-bench et a trouvé la donnée la plus éloquente de l'année : pour un même modèle, changer de scaffold fait varier le résultat jusqu'à 29,8 points de pourcentage, alors que l'ensemble du top 30 tient en 8,8 points. En d'autres termes : la différence entre les harnais est plus de trois fois supérieure à la distance entre les trente meilleurs systèmes au monde. Leurs auteurs demandent que le binôme modèle-harnais soit toujours déclaré.
Un article de position de mai 2026 le dit sans détour : le harness d'exécution « est souvent un déterminant plus fort de la performance de l'agent que le modèle qu'il enveloppe », et tant que le harnais utilisé n'est pas publié, les comparaisons de leaderboard devraient être considérées comme incomplètes et potentiellement trompeuses. La propre Anthropic le formule plus simplement : « lorsque nous évaluons "un agent", nous évaluons le harness et le modèle travaillant ensemble ».
Et cela coûte de l'argent. Dans une expérience d'Anthropic de mars 2026 sur le développement d'applications de longue durée, la même tâche lancée sans harnais a été résolue en 20 minutes et 9 dollars, tandis qu'avec le harnais complet, elle a pris près de six heures et a coûté environ 200 dollars. La différence n'est pas le prix : c'est que le premier était un brouillon et le second, une application aboutie. Le harnais est ce qui transforme une démo en travail.
La conséquence pratique est inconfortable pour le marketing du secteur : lorsque vous comparez deux produits d'IA, une grande partie de la différence ne réside pas dans le modèle, qui est souvent littéralement le même. Le modèle s'achète ; le harnais se construit.
Anatomie d'un harness
Un harness digne de ce nom résout six choses :
- La boucle. Appeler le modèle, exécuter ce qu'il demande, lui renvoyer le résultat et recommencer jusqu'à terminer ou jusqu'à épuiser la limite. Facile à décrire, difficile à bien faire : c'est ici que se décident les coûts et les blocages.
- Les outils. Ce que l'agent peut réellement faire : lire un courriel, consulter l'ERP, créer un événement, ouvrir un ticket. La façon dont on les décrit et les nomme change les performances autant que de changer de modèle.
- Le contexte. Ce qui entre dans la fenêtre de contexte à chaque étape et ce qui est résumé, écarté ou stocké à l'extérieur. C'est le goulot d'étranglement de toutes les tâches longues.
- Les permissions. Ce qu'il peut faire sans demander et ce qui exige une confirmation humaine. C'est la différence entre un assistant utile et un incident.
- La mémoire et l'état. Ce qui survit entre les étapes et entre les exécutions, et si une tâche interrompue reprend là où elle s'était arrêtée. Anthropic identifie précisément ici le problème central des agents de longue durée : ils travaillent dans des sessions séparées et chaque nouvelle session commence sans souvenir de ce qui précède.
- L'observabilité. Traces, journaux et rejeu étape par étape. Sans cela, on ne débogue pas un agent : on devine.
Il existe un septième détail peu intuitif qui mérite d'être mentionné : les agents sont de mauvais juges de leur propre travail. Lorsqu'on leur demande d'évaluer ce qu'ils viennent de produire, ils ont tendance à le complimenter même si la qualité est médiocre. C'est pourquoi les bons harness séparent l'agent qui travaille de l'agent qui juge.
Si vous voulez la version courte et reliée au reste du vocabulaire, vous la trouverez dans la fiche Harness de la NAiOS Wiki, aux côtés de Scaffold, Loop engineering et Guardrails.
Pourquoi cela justifie de demander la permission
Il existe une raison sérieuse derrière la manie des harnais rigoureux à demander confirmation. Le benchmark τ-bench, qui mesure des agents conversant avec des clients et appliquant des règles métier, a constaté que des agents de pointe résolvaient moins de 50 % des tâches, et qu'en répétant la même tâche huit fois, ils réussissaient les huit fois dans moins de 25 % des cas. La conclusion n'est pas que les agents sont inutiles : c'est que la cohérence ne va pas de soi, et c'est pourquoi les actions à conséquences ne devraient pas s'exécuter sans que quelqu'un regarde.
Comment NAiOS gère le harnais
Chez NAiOS, nous n'utilisons pas un seul modèle : nous utilisons le meilleur disponible à chaque instant et nous en changeons dès qu'un meilleur apparaît. Ce qui ne change pas, c'est le harnais. Voici les modules qui le composent.
NAiOS Agents : la boucle
NAiOS Agents est la couche qui transforme le chat réactif en agents qui travaillent seuls. Elle exécute une boucle durable plan→act→observe avec un worker en arrière-plan, de sorte qu'une tâche longue survit à un redémarrage et reprend là où elle en était : précisément le problème de mémoire entre sessions dont nous parlions. Elle inclut une exécution manuelle ou programmée (par cron ou par événement), mémoire et base de connaissances par agent, délégation à d'autres agents, workspace isolé et une timeline reproductible pour voir, étape par étape, ce qu'il a pensé et ce qu'il a fait. Ce dernier point, c'est l'observabilité : quand quelque chose paraît étrange, on regarde, on ne devine pas.
Connectors et MCP : les outils
Un agent sans outils est un chat qui se donne des airs. NAiOS Connectors connecte par OAuth plus de mille services —Gmail, Slack, GitHub, Calendar, Notion et compagnie— et les expose comme outils deny-by-default : seuls parviennent au modèle ceux des connecteurs que vous avez activés, isolés par utilisateur. NAiOS MCP fait de même avec tout serveur MCP que vous enregistrez, en classant chaque outil en lecture ou sensible.
Knowledge Base : le contexte
La RAG Knowledge Base alimente la fenêtre de contexteFenêtre de contexteQuantité de texte qu'un modèle peut mémoriser dans une conversation avec ce que sait votre entreprise : documents, feuilles de calcul, catalogues, audio et vidéo, avec recherche sémantique et requêtes SQL générées par IA. Un agent qui ne peut pas consulter vos connaissances improvise ; celui qui le peut répond avec vos données.
HITL : les permissions
La règle est fixe sur toute la plateforme : lire est libre, agir demande une autorisation. Les actions ayant des effets — envoyer un e-mail, publier, écrire dans un service externe, émettre une facture — s'arrêtent sur une carte de confirmation qui montre ce qui va être fait et avec quel compte. Les outils à haut risque conservent cette confirmation même chez les agents auto-approuvés. D'où vient cette façon de travailler, nous le racontons dans L'origine du HITL.
Quatre cas d'usage réels
- La clôture du matin. Un agent programmé à 7h00 examine les e-mails de la nuit avec NAiOS Mail, classe les urgences, croise chaque expéditeur avec le CRM et vous laisse un résumé avec des brouillons de réponse préparés. Aucun n'est envoyé sans votre clic.
- Un service client qui sait s'effacer. Dans NAiOSOmni, un agent répond via WhatsApp ou Telegram avec la connaissance de votre KB et se met en pause automatiquement dès qu'une personne de l'équipe entre dans la conversation. Le harness décide quand l'agent se tait.
- Des réunions qui laissent des tâches, pas des notes. Meeting Agent entre dans la visioconférence, transcrit avec diarisation et produit un résumé et des action items ; l'agent les convertit en tâches assignées. Tout le travail fastidieux d'après-réunion, fait.
- Une surveillance continue de l'activité. Un agent récurrent examine chaque nuit la trésorerie, le stock ou les campagnes actives et n'avertit que lorsque quelque chose sort de l'ordinaire. Il surveille, il n'agit pas : la décision reste la vôtre.
Comment savoir si votre plateforme dispose d'un bon harness
Quatre questions pour toute démo, embarrassantes à répondre si le harness est faible :
- Si la tâche est interrompue en cours, reprend-elle toute seule ou faut-il repartir de zéro ?
- Puis-je voir, étape par étape, ce qu'a fait l'agent la semaine dernière et avec quelles données ?
- Quelles actions peut-il exécuter sans me demander, et qui décide de cette liste ?
- Si un meilleur modèle sort demain, puis-je le changer sans refaire mes automatisations ?
Quand vous changez de modèle et que tout continue de fonctionner, c'est que vous aviez un harness. Quand vous changez de modèle et que la moitié du système se casse, c'est que vous aviez un prompt qui avait de la chance.
En résumé
- Le harness est l'environnement qui entoure le modèle : boucle, outils, contexte, permissions, mémoire et traces. Agent = modèle + harness.
- Le nom vient du harnais : le faisceau de câbles d'un véhicule et le test harness du logiciel classique. Ce qui est né en 2026, c'est la discipline, pas le mot.
- Les données de cette année sont probantes : un même modèle et un harnais différent changent le résultat plus que le choix d'un autre modèle.
- Le modèle s'achète et se change ; le harnais se construit, et c'est là que réside la différence réelle entre les produits.
- Chez NAiOS, ce harnais a un nom et des modules : Agents pour la boucle, Connectors et MCPModel Context Protocol (MCP)Protocole standard pour que les modèles se connectent à des outils externes pour les outils, Knowledge Base pour le contexte et HITL pour les permissions.
Sources
- Anthropic, Demystifying evals for AI agents — 9 janvier 2026. Définition de l'agent harness et pourquoi une évaluation mesure toujours le modèle et le harnais ensemble.
- LangChain, Improving Deep Agents with harness engineering — 17 février 2026. De 52,8 % à 66,5 % sur Terminal-Bench 2.0 sans toucher au modèle.
- Anthropic, Harness design for long-running application development — 24 mars 2026. Coût et durée avec et sans harnais, et pourquoi il convient de séparer celui qui travaille de celui qui juge.
- LangChain, The Anatomy of an Agent Harness — 10 mars 2026. « Agent = modèle + harness » et les éléments qui le composent.
- Zhang et al., Stop Comparing LLM Agents Without Disclosing the Harness — arXiv, 7 mai 2026. Le harnais comme déterminant de la performance au-delà du modèle.
- Liu et al., Coding Agents Have Converged — arXiv, 15 septembre 2026. Audit de 254 soumissions à SWE-bench : 29,8 points de variation dus au harnais contre 8,8 points pour l'ensemble du top 30.
- Microsoft, Agent Harness (Microsoft Agent Framework) — mis à jour en septembre 2026. Le harness comme concept produit documenté.
- Yao et al., τ-bench — arXiv, 2024. Fiabilité des agents lors de la répétition d'une même tâche.