Durante 2026 la palabra harnessHarnessLa infraestructura que rodea al modelo y lo convierte en agente: bucle, herramientas, contexto, permisos y trazas se ha colado en todas las conversaciones sobre agentes de IAAI AgentsSistemas que ejecutan tareas multi-paso sin supervisión constante. Se habla del «harness de Claude Code», de «cambiar de harness» o de que «el harness importa más que el modelo». Hasta ha nacido una disciplina con nombre propio, harness engineering, cuya paternidad se disputan un artículo de Mitchell Hashimoto de febrero de 2026 y otro de LangChain de marzo. Suena a término recién inventado, pero no lo es: los electricistas de automoción llevan un siglo montando harnesses y los programadores llevan décadas escribiéndolos. Lo único nuevo es a qué se lo aplicamos.
Qué es un harness, en una frase
La definición más clara es la que usa Anthropic en su guía de evaluación de agentes: «un harness de agente (o scaffoldScaffoldLa estructura de código que conecta y orquesta a un agente de IA) es el sistema que permite a un modelo actuar como agente: procesa las entradas, orquesta las llamadas a herramientas y devuelve los resultados». Dicho en corto: es todo lo que rodea al modelo para que pueda trabajar. El bucle que decide cuándo volver a llamarlo, las herramientas que puede usar, el contexto que le llega en cada paso, los permisos que lo limitan y las trazas que registran lo que hizo.
LangChain lo resume con una ecuación que se ha hecho popular este año: agente = modelo + harness. Un modelo en crudo no es un agente; se convierte en uno cuando un arnés le da estado, ejecución de herramientas, bucles de realimentación y límites que se pueden hacer cumplir.
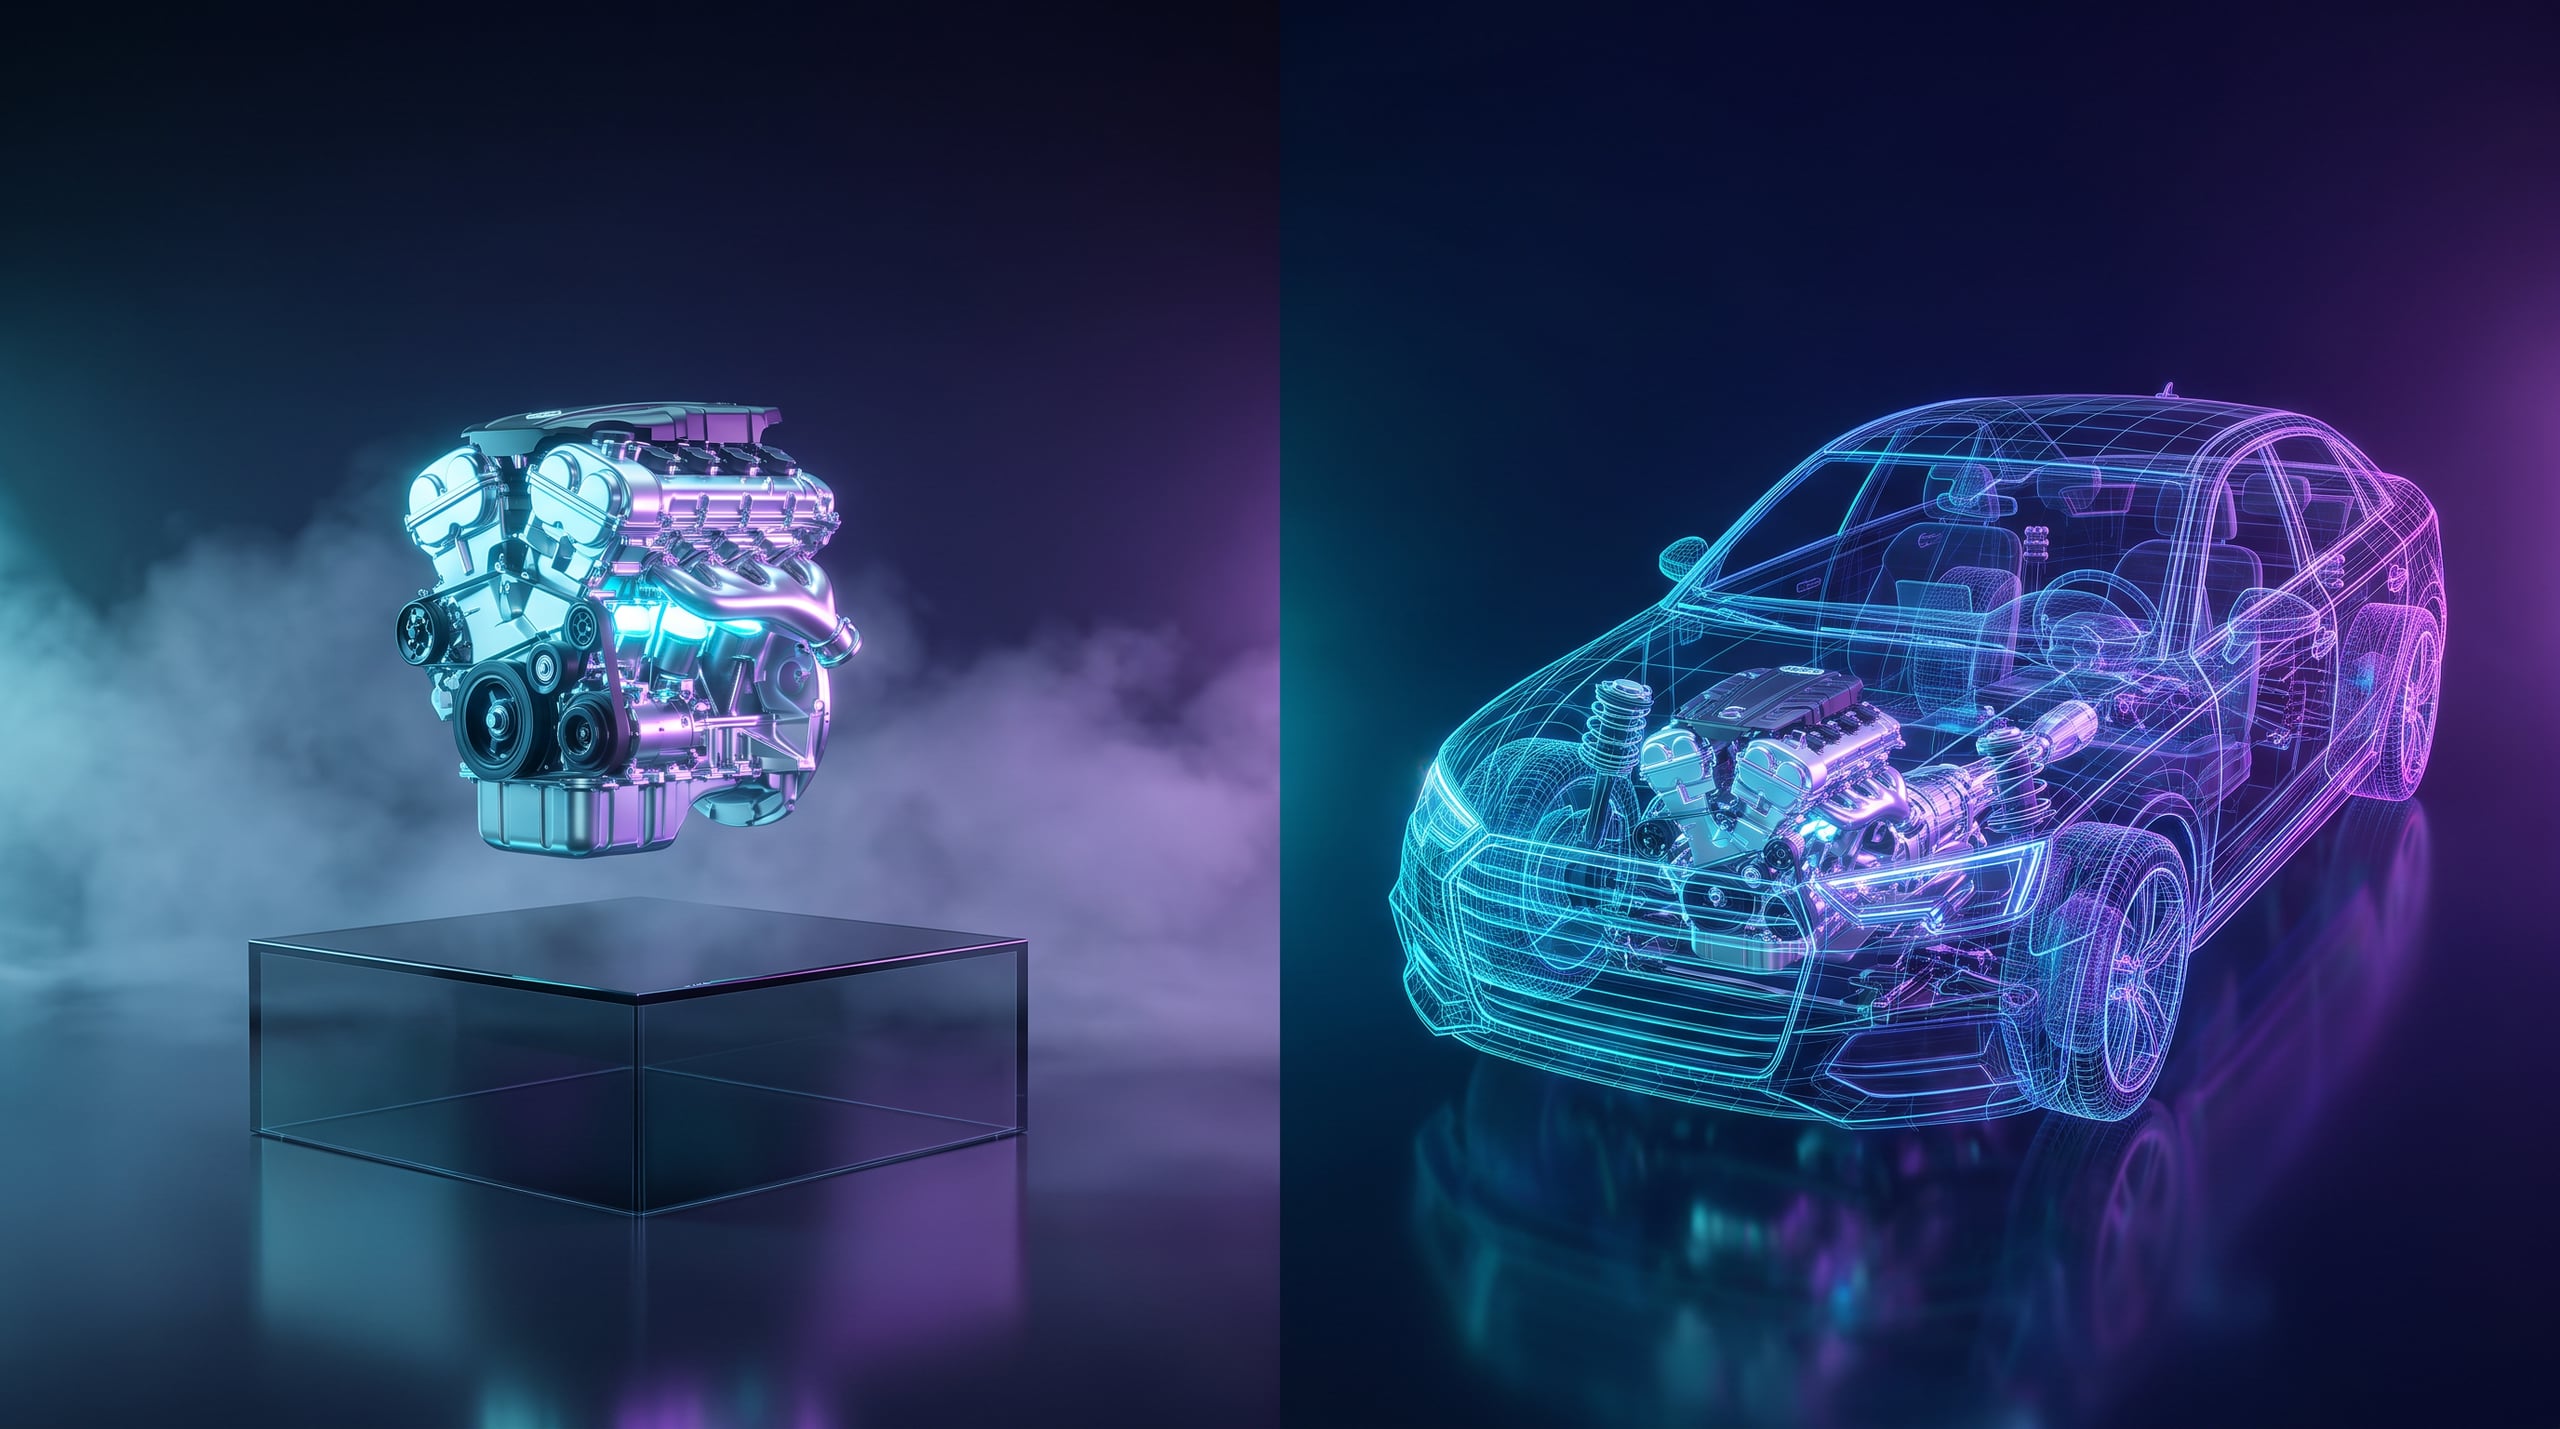
La imagen que mejor lo explica: el modelo es el motor y el harness es el resto del coche. Chasis, transmisión, frenos, dirección, cuadro de mandos. Un motor excelente sobre una mesa no te lleva a ningún sitio, y el mismo motor rinde de forma muy distinta según el vehículo donde lo montes.
De dónde viene el nombre
Harness significa arnés: las correas que sujetan a un animal de tiro, o el equipo que impide caer a quien trabaja en altura. La ingeniería ya se había quedado con la palabra dos veces antes de que llegara a la inteligencia artificial.
El arnés de cables
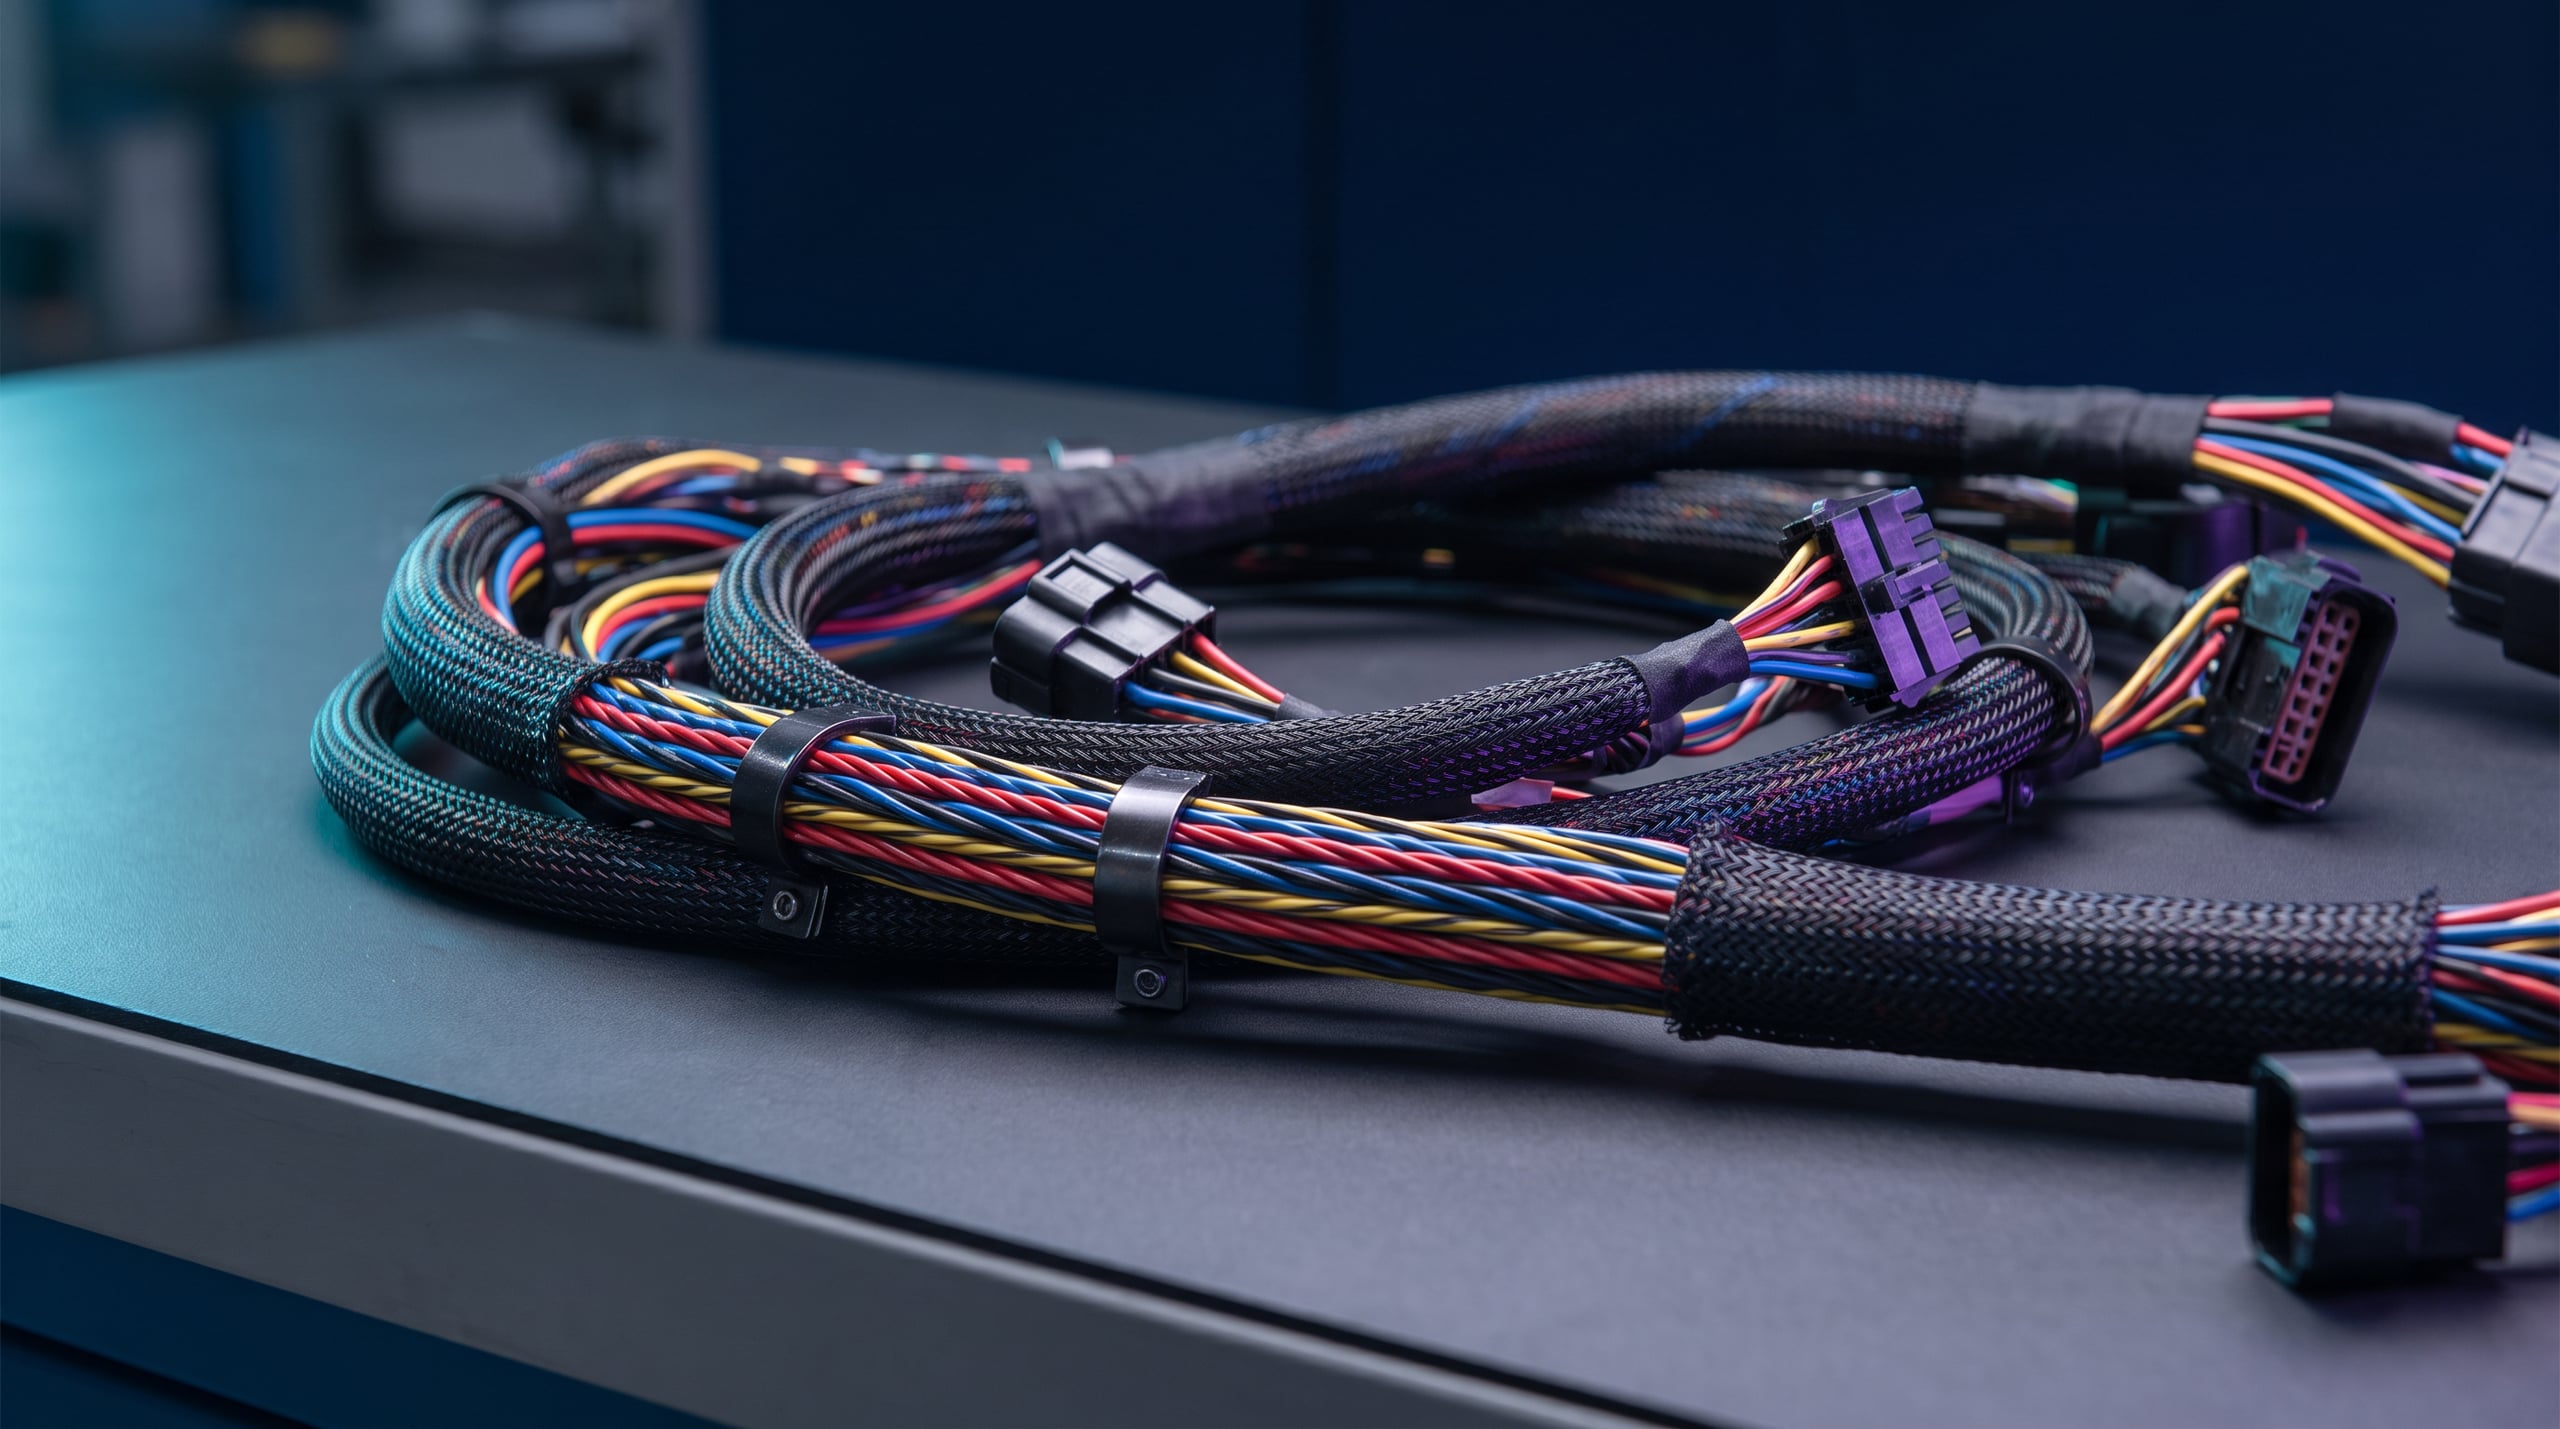
En automoción y aviación, un wiring harness es el mazo de cables que recorre el vehículo y conecta el motor con el cuadro, las luces, los sensores y la centralita: cables agrupados y atados con una funda resistente, rematados con conectores. Se popularizó en la industria del automóvil en los años veinte, cuando quedó claro que los cables sueltos no sobrevivían a la vibración, la abrasión y la humedad. Un avión moderno lleva dentro mazos que, estirados, sumarían kilómetros.
Lo interesante para nuestra analogía es que el arnés no hace nada por sí mismo: conecta, ordena y protege lo que ya existe. Sin él, ninguna pieza habla con las demás.
El arnés de pruebas
En software, un test harness es el conjunto de stubs y drivers que rodea a una pieza de programa para poder ejecutarla de forma controlada: le inyecta entradas, recoge salidas, las compara con lo esperado y deja un informe. Es infraestructura de imitación que permite automatizar las pruebas, y es vocabulario corriente en ingeniería de software desde hace décadas.
Es exactamente la misma idea que hoy se aplica a los agentes: una estructura externa que sujeta a la pieza, la alimenta y observa lo que hace. Cuando los modelos de lenguaje empezaron a usar herramientas y a encadenar pasos, hacía falta un nombre para el código que los envuelve. El término estaba esperando en el armario.
Dos sentidos que conviene no mezclar
- Harness de ejecución (agent harness): el entorno que hace funcionar al agente en producción. Es el sentido dominante y el que se usa cuando alguien dice «el harness de Claude Code». Microsoft lo ha convertido incluso en nomenclatura oficial de producto: en su documentación de septiembre de 2026 define el harness como «el andamiaje de ejecución que convierte un modelo de lenguajeLLM (Large Language Model)Modelo de lenguaje grande, la base de los chatbots actuales en un agente capaz de trabajar».
- Harness de evaluación (evaluation harness): el andamiaje que ejecuta una batería de pruebas contra un modelo para medirlo de forma reproducible. Es el heredero directo del test harness clásico.
Son primos hermanos: en ambos casos hay una estructura externa que sujeta al modelo y observa su comportamiento. Y en ambos casos, quien construye el arnés condiciona el resultado.
Por qué el harness decide el resultado
Esta es la parte que le interesa a una empresa, y en 2026 ha dejado de ser una opinión para convertirse en un dato.
Mismo modelo, distinto arnés, otro resultado. En febrero de 2026, LangChain publicó un experimento limpio: congelaron el modelo (GPT-5.2-Codex) y trabajaron solo el harness. Su puntuación en Terminal-Bench 2.0 pasó del 52,8 % al 66,5 %, casi catorce puntos, saltando de fuera del top 30 al top 5 de la clasificación. Su propio resumen: «solo cambiamos el harness». Lo que tocaron fueron bucles de auto-verificación, inyección de contexto del entorno, detección de bucles infinitos y análisis automático de trazas. Nada de eso es el modelo.
Las tablas de clasificación miden parejas, no modelos. Un estudio de septiembre de 2026 auditó 254 envíos al leaderboard de SWE-bench y encontró el dato más elocuente del año: para un mismo modelo, cambiar de scaffold mueve el resultado hasta 29,8 puntos porcentuales, mientras que todo el top 30 cabe en 8,8 puntos. Dicho de otro modo: la diferencia entre arneses es más de tres veces mayor que la distancia entre los treinta mejores sistemas del mundo. Sus autores piden que se declare siempre la pareja modelo-arnés.
Un artículo de posición de mayo de 2026 lo dice sin rodeos: el harness de ejecución «es a menudo un determinante más fuerte del rendimiento del agente que el modelo al que envuelve», y mientras no se publique qué arnés se usó, las comparaciones de leaderboard deberían tratarse como incompletas y potencialmente engañosas. La propia Anthropic lo formula de forma más sencilla: «cuando evaluamos "un agente", estamos evaluando el harness y el modelo trabajando juntos».
Y cuesta dinero. En un experimento de Anthropic de marzo de 2026 sobre desarrollo de aplicaciones de larga duración, el mismo encargo lanzado sin arnés se resolvió en 20 minutos y 9 dólares, mientras que con el arnés completo tardó casi seis horas y costó unos 200 dólares. La diferencia no es el precio: es que lo primero era un borrador y lo segundo, una aplicación terminada. El arnés es lo que convierte una demo en trabajo.
La consecuencia práctica es incómoda para el marketing del sector: cuando comparas dos productos de IA, buena parte de la diferencia no está en el modelo, que muchas veces es literalmente el mismo. El modelo se compra; el arnés se construye.
Anatomía de un harness
Un arnés digno de ese nombre resuelve seis cosas:
- El bucle. Llamar al modelo, ejecutar lo que pida, devolverle el resultado y repetir hasta terminar o hasta agotar el límite. Fácil de describir, difícil de hacer bien: aquí se deciden los costes y los bloqueos.
- Las herramientas. Lo que el agente puede hacer de verdad: leer correo, consultar el ERP, crear un evento, abrir una incidencia. Cómo se describen y se nombran cambia el rendimiento tanto como cambiar de modelo.
- El contexto. Qué entra en la ventana de contexto en cada paso y qué se resume, se descarta o se guarda fuera. Es el cuello de botella de todas las tareas largas.
- Los permisos. Qué puede hacer sin preguntar y qué exige confirmación humana. Es la diferencia entre un asistente útil y un incidente.
- La memoria y el estado. Qué sobrevive entre pasos y entre ejecuciones, y si una tarea interrumpida se retoma donde se quedó. Anthropic identifica justo aquí el problema central de los agentes de larga duración: trabajan en sesiones separadas y cada sesión nueva empieza sin recuerdo de lo anterior.
- La observabilidad. Trazas, registros y reproducción paso a paso. Sin esto no se depura un agente: se adivina.
Hay un séptimo detalle poco intuitivo que merece mención: los agentes son malos jueces de su propio trabajo. Cuando se les pide evaluar lo que acaban de producir, tienden a elogiarlo aunque la calidad sea mediocre. Por eso los buenos arneses separan al agente que trabaja del agente que juzga.
Si quieres la versión corta y enlazada con el resto del vocabulario, la tienes en la ficha Harness de la NAiOS Wiki, junto a Scaffold, Loop engineering y Guardrails.
Por qué esto justifica pedir permiso
Hay una razón dura detrás de la manía de los arneses serios por pedir confirmación. El benchmark τ-bench, que mide agentes conversando con clientes y aplicando reglas de negocio, encontró que agentes punteros resolvían menos del 50 % de las tareas, y que al repetir la misma tarea ocho veces acertaban las ocho en menos del 25 % de los casos. La conclusión no es que los agentes no sirvan: es que la consistencia no se da por supuesta, y por eso las acciones con consecuencias no deberían ejecutarse sin alguien mirando.
Cómo gestiona NAiOS el harness
En NAiOS no usamos un modelo: usamos el mejor disponible en cada momento y lo cambiamos cuando aparece uno mejor. Lo que no cambia es el arnés. Estos son los módulos que lo forman.
NAiOS Agents: el bucle
NAiOS Agents es la capa que convierte el chat reactivo en agentes que trabajan solos. Ejecuta un bucle durable plan→act→observe con un worker de fondo, de modo que una tarea larga sobrevive a un reinicio y se retoma donde estaba: justo el problema de memoria entre sesiones del que hablábamos. Incluye ejecución manual o programada (por cron o por evento), memoria y base de conocimiento por agente, delegación a otros agentes, workspace aislado y un timeline reproducible para ver, paso a paso, qué pensó y qué hizo. Eso último es la observabilidad: cuando algo sale raro, se mira, no se adivina.
Connectors y MCP: las herramientas
Un agente sin herramientas es un chat con ínfulas. NAiOS Connectors conecta por OAuth más de mil servicios —Gmail, Slack, GitHub, Calendar, Notion y compañía— y los expone como herramientas deny-by-default: solo llegan al modelo las de los conectores que tú has habilitado, aisladas por usuario. NAiOS MCP hace lo propio con cualquier servidor MCP que registres, clasificando cada herramienta en lectura o sensible.
Knowledge Base: el contexto
La RAG Knowledge Base alimenta la ventana de contextoContext WindowCantidad de texto que un modelo puede recordar en una conversación con lo que sabe tu empresa: documentos, hojas de cálculo, catálogos, audio y vídeo, con búsqueda semántica y consultas SQL generadas por IA. Un agente que no puede consultar tu conocimiento improvisa; uno que sí, responde con tus datos.
HITL: los permisos
La regla es fija en toda la plataforma: leer es libre, actuar pide permiso. Las acciones con efectos —enviar un correo, publicar, escribir en un servicio externo, emitir una factura— se detienen en una tarjeta de confirmación que muestra qué se va a hacer y con qué cuenta. Las herramientas de alto riesgo mantienen esa confirmación incluso en agentes auto-aprobados. De dónde viene esa forma de trabajar lo contamos en El origen de HITL.
Cuatro casos de uso reales
- El cierre de la mañana. Un agente programado a las 7:00 revisa el correo de la noche con NAiOS Mail, clasifica lo urgente, cruza cada remitente con el CRM y te deja un resumen con borradores de respuesta preparados. Ninguno se envía sin tu clic.
- Atención al cliente que sabe apartarse. En NAiOSOmni, un agente responde por WhatsApp o Telegram con el conocimiento de tu KB y se pausa automáticamente en cuanto una persona del equipo entra en la conversación. El harness decide cuándo el agente calla.
- Reuniones que dejan tareas, no notas. Meeting Agent entra en la videollamada, transcribe con diarización y saca resumen y action items; el agente los convierte en tareas asignadas. Todo el trabajo aburrido de después de la reunión, hecho.
- Vigilancia continua del negocio. Un agente recurrente revisa cada noche tesorería, stock o campañas activas y avisa solo cuando algo se sale de lo normal. Vigila, no actúa: la decisión sigue siendo tuya.
Cómo saber si tu plataforma tiene un buen harness
Cuatro preguntas para cualquier demo, incómodas de responder si el arnés es flojo:
- Si la tarea se interrumpe a mitad, ¿se retoma sola o hay que empezar de cero?
- ¿Puedo ver, paso a paso, qué hizo el agente la semana pasada y con qué datos?
- ¿Qué acciones puede ejecutar sin preguntarme, y quién decide esa lista?
- Si mañana sale un modelo mejor, ¿puedo cambiarlo sin rehacer mis automatizaciones?
Cuando cambias de modelo y todo sigue funcionando, es que tenías un harness. Cuando cambias de modelo y se rompe medio sistema, es que tenías un prompt con suerte.
En resumen
- El harness es el entorno que rodea al modelo: bucle, herramientas, contexto, permisos, memoria y trazas. Agente = modelo + harness.
- El nombre viene del arnés: el mazo de cables de un vehículo y el test harness del software clásico. Lo que nació en 2026 es la disciplina, no la palabra.
- Los datos de este año son contundentes: mismo modelo y distinto arnés cambian el resultado más que elegir otro modelo.
- El modelo se compra y se cambia; el arnés se construye, y ahí está la diferencia real entre productos.
- En NAiOS ese arnés tiene nombre y módulos: Agents para el bucle, Connectors y MCPModel Context Protocol (MCP)Protocolo estándar para que los modelos se conecten con herramientas externas para las herramientas, Knowledge Base para el contexto y HITL para los permisos.
Fuentes
- Anthropic, Demystifying evals for AI agents — 9 de enero de 2026. Definición de agent harness y por qué una evaluación mide siempre el modelo y el arnés juntos.
- LangChain, Improving Deep Agents with harness engineering — 17 de febrero de 2026. Del 52,8 % al 66,5 % en Terminal-Bench 2.0 sin tocar el modelo.
- Anthropic, Harness design for long-running application development — 24 de marzo de 2026. Coste y duración con y sin arnés, y por qué conviene separar quien trabaja de quien juzga.
- LangChain, The Anatomy of an Agent Harness — 10 de marzo de 2026. «Agente = modelo + harness» y las piezas que lo componen.
- Zhang et al., Stop Comparing LLM Agents Without Disclosing the Harness — arXiv, 7 de mayo de 2026. El arnés como determinante del rendimiento por encima del modelo.
- Liu et al., Coding Agents Have Converged — arXiv, 15 de septiembre de 2026. Auditoría de 254 envíos a SWE-bench: 29,8 puntos de variación por arnés frente a 8,8 puntos de todo el top 30.
- Microsoft, Agent Harness (Microsoft Agent Framework) — actualizado en septiembre de 2026. El harness como concepto de producto documentado.
- Yao et al., τ-bench — arXiv, 2024. Fiabilidad de los agentes al repetir la misma tarea.