Qué es Cerebras AI: La Revolución en la Inferencia de IA y su Integración con NAiOS.net*
En el vertiginoso ecosistema de la inteligencia artificial, la velocidad de procesamiento y la capacidad de respuesta se han convertido en los principales cuellos de botella para las empresas. A medida que los modelos de lenguaje (LLMs) crecen en tamaño y complejidad, las infraestructuras tradicionales basadas en GPUs a menudo luchan por mantener una latencia baja sin disparar los costos. Es en este escenario donde surge Cerebras AI (https://www.cerebras.ai/), una empresa que está redefiniendo los límites del hardware para inteligencia artificial.
En este artículo, exploraremos en profundidad qué es Cerebras, por qué su nuevo acelerador CS-4 está cambiando las reglas del juego, cómo está impactando en diversas industrias y, lo más importante, cómo puedes aprovechar todo este potencial a través de su integración con naios.net.
¿Qué es Cerebras AI?
Cerebras Systems es una compañía de tecnología especializada en la creación de hardware y software diseñado exclusivamente para acelerar la inteligencia artificial. A diferencia de los enfoques tradicionales que conectan miles de pequeños chips (GPUs) a través de redes complejas, Cerebras ha adoptado un enfoque radicalmente distinto: el Wafer-Scale Engine (WSE).
En lugar de cortar una oblea de silicio en cientos de chips individuales, Cerebras utiliza la oblea completa para crear un único procesador gigante. Esto elimina los retrasos en la comunicación entre chips, permitiendo un ancho de banda masivo y una velocidad de procesamiento que las arquitecturas convencionales simplemente no pueden igualar.
El resultado de esta innovación es una plataforma que permite entrenar, ajustar (fine-tune) y servir modelos de IA en una única infraestructura, optimizando todo el ciclo de vida del aprendizaje automático.
Cerebras CS-4: La IA más rápida, ahora aún más veloz
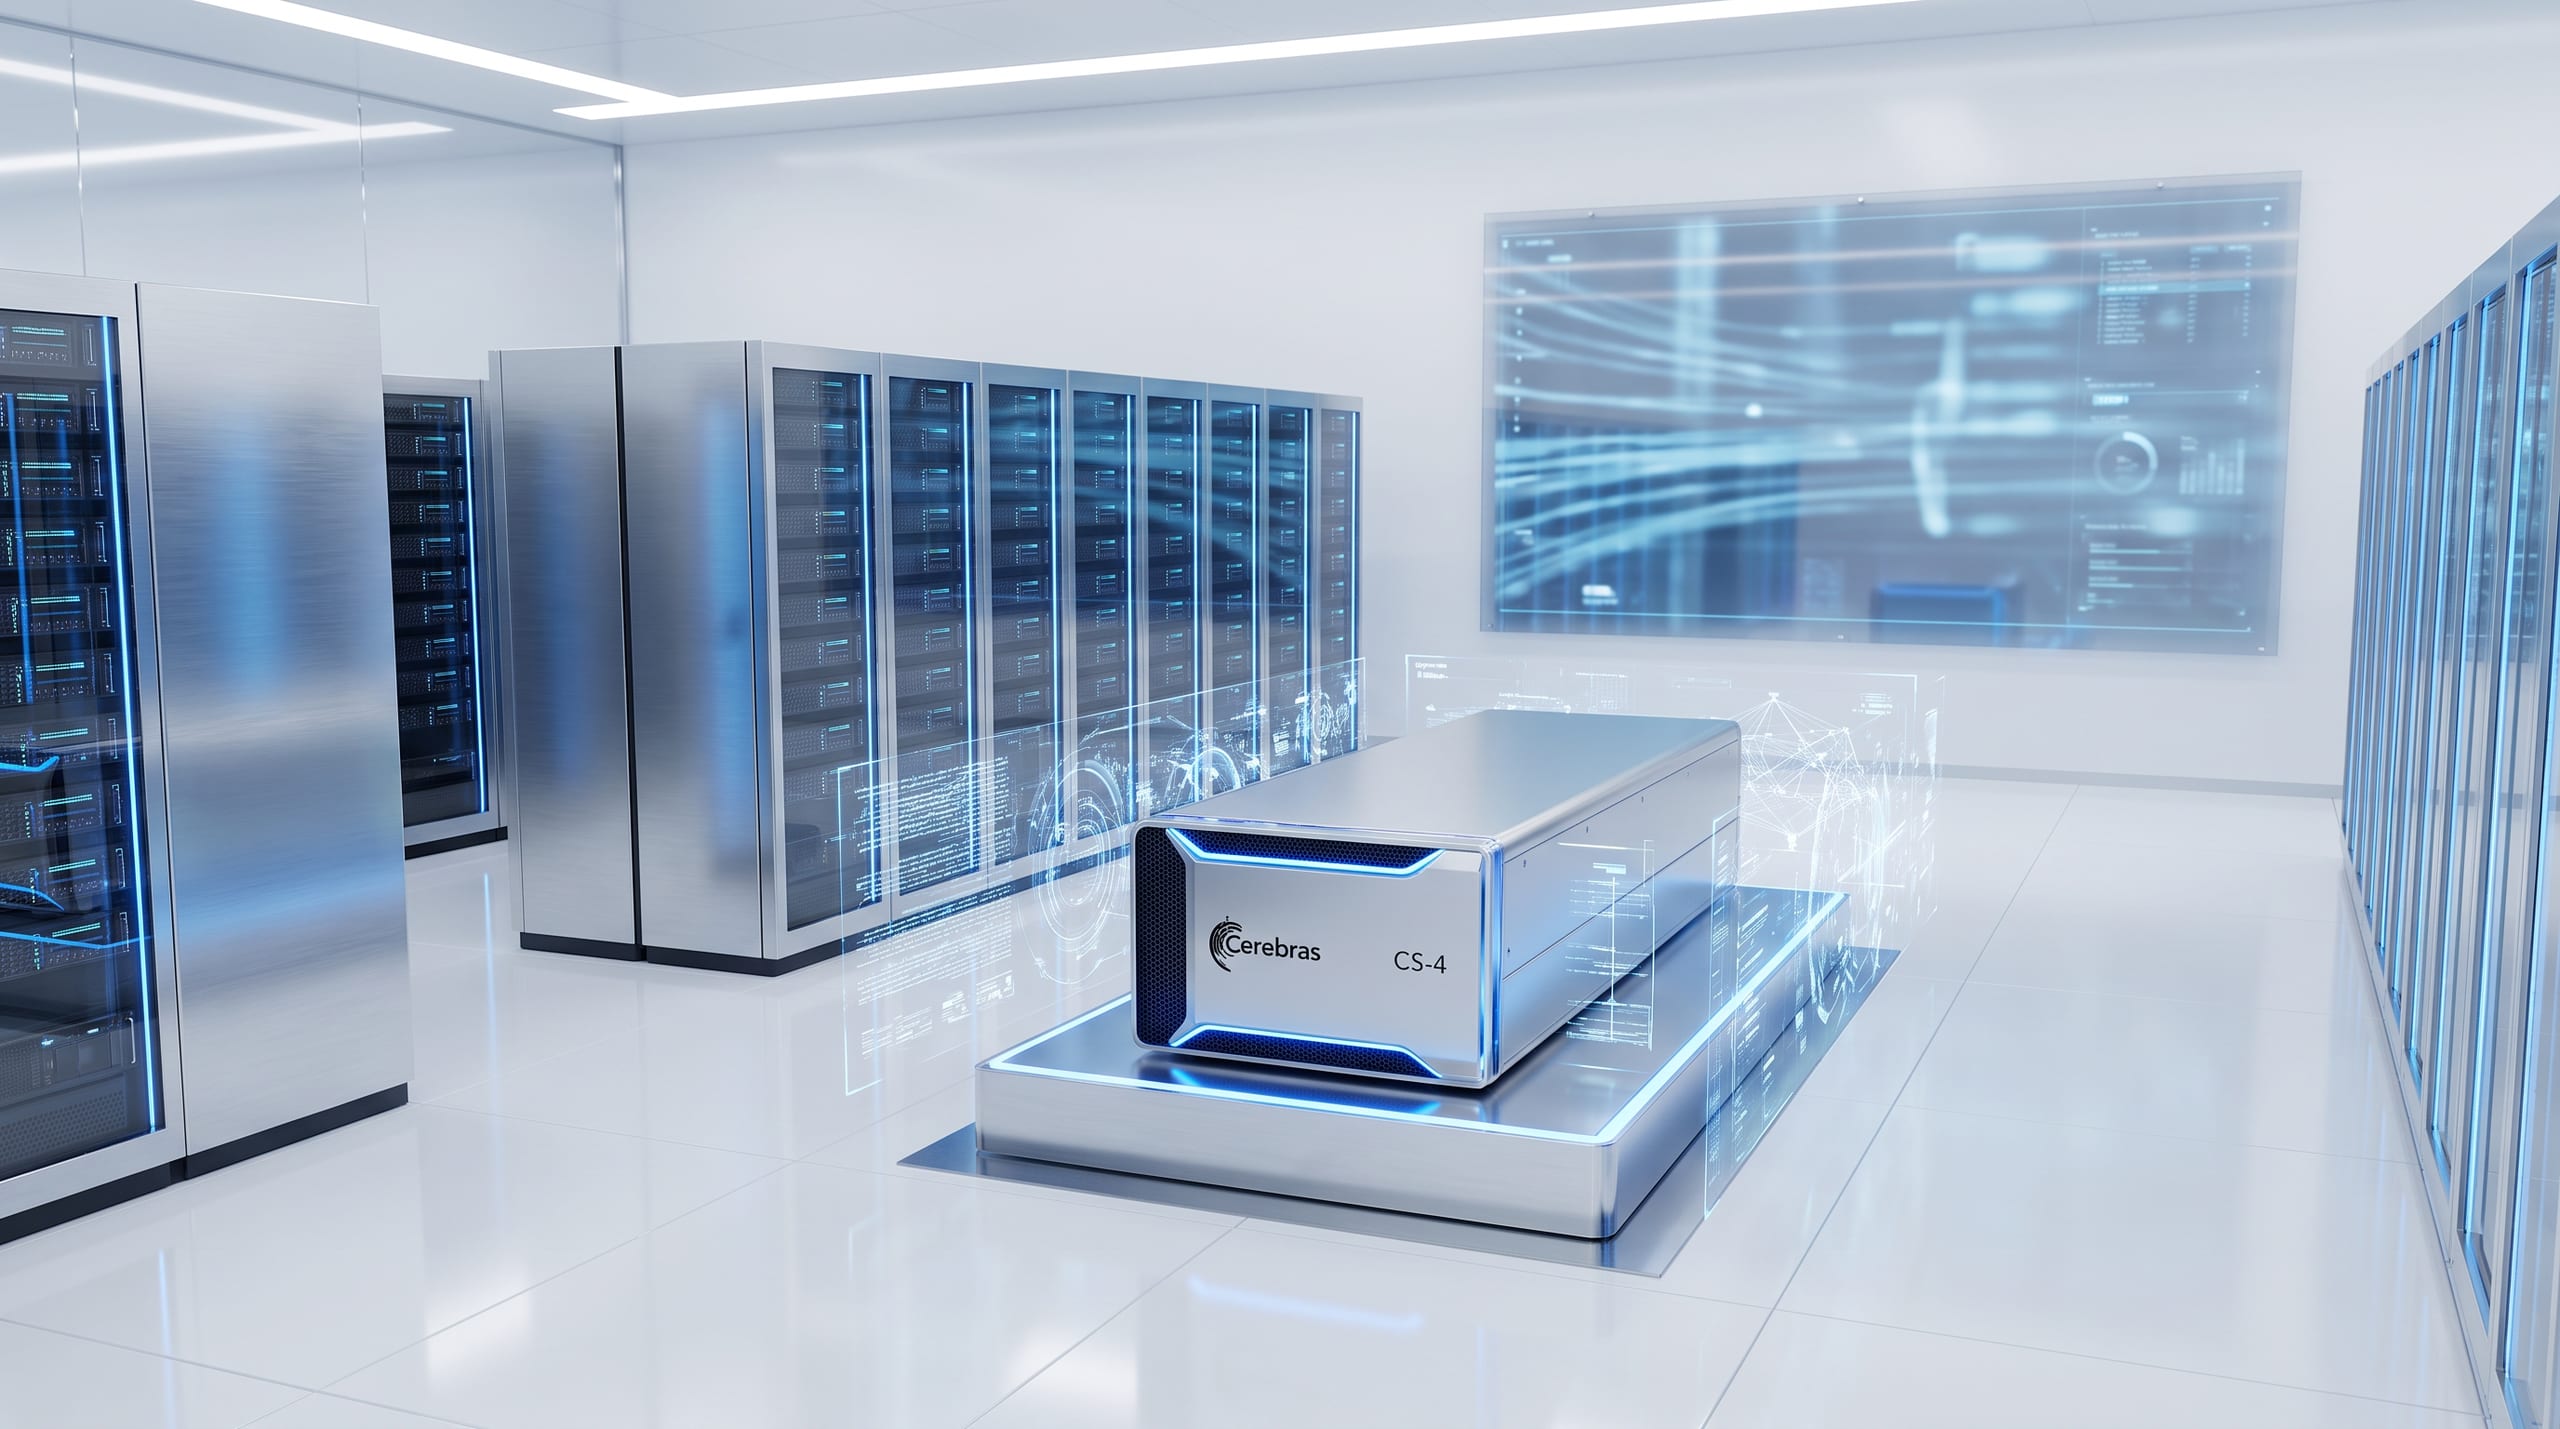
El producto estrella actual de la compañía es el Cerebras CS-4, una solución a escala de rack (rack-scale) que ofrece una inferencia hasta 30 veces más rápida en comparación con las GPUs tradicionales. Diseñado para implementaciones a hiperescala, el CS-4 se posiciona como la infraestructura más rápida del mundo para la "Frontier AIFrontier ModelsLos modelos más avanzados y potentes en cada momento" (los modelos de IA más avanzados).
Para poner esta velocidad en perspectiva, modelos de vanguardia como el GPT-5.6 Sol Ultrafast de OpenAI están disponibles en la plataforma de Cerebras funcionando a velocidades asombrosas de hasta 750 tokens por segundo. Otros modelos líderes que aprovechan esta arquitectura incluyen QWEN 3.8 27B, Kimi K2.6 y Codex-Spark.
La alianza con AMD para la Inferencia Desagregada
Cerebras no trabaja de forma aislada. Su reciente asociación con AMD demuestra un enfoque innovador llamado "inferencia desagregada". En esta arquitectura, los sistemas AMD Helios se combinan con el Wafer-Scale Engine de Cerebras. AMD maneja el "prefill" (el procesamiento inicial del contexto) con un alto rendimiento, mientras que Cerebras se encarga de la generación de tokens a velocidades ultrarrápidas. Esta sinergia maximiza la eficiencia y reduce drásticamente el tiempo de respuesta.
Ventajas Competitivas de Cerebras
Adoptar la tecnología de Cerebras ofrece beneficios tangibles que permiten a las empresas construir productos que antes eran inviables debido a las limitaciones de latencia:
Velocidad y calidad sin precedentes: Al disponer de una inferencia más rápida, los modelos tienen un mayor "presupuesto de latencia" para realizar razonamientos complejos (Chain of ThoughtChain of Thought (CoT)Técnica donde la IA piensa paso a paso antes de responder) sin hacer esperar al usuario. Esto se traduce en respuestas de mayor calidad en el mismo tiempo.
Liderazgo en Precio-Rendimiento: Cerebras permite reducir drásticamente los costos de infraestructura de IA en comparación con las nubes basadas en GPU, logrando al mismo tiempo un rendimiento hasta 30 veces superior.
Facilidad para Desarrolladores: La plataforma está probada a escala empresarial. Los desarrolladores pueden comenzar a usarla en menos de 30 segundos gracias a su compatibilidad directa (drop-in) con la API de OpenAI.
Ciclo completo en una plataforma: Puedes comenzar con inferencia ultrarrápida y, posteriormente, realizar fine-tuningFine-TuningReentrenar un modelo con datos específicos para un caso de uso o preentrenamiento con tus propios datos para optimizar los modelos según tus casos de uso específicos.
Casos de Uso y Testimonios de Líderes del Sector
La velocidad de Cerebras habilita nuevos paradigmas de interacción humano-computadora. Algunas de las empresas más innovadoras del mundo ya están aprovechando esta tecnología:
Desarrollo de Software a la velocidad del pensamiento: Empresas como Lovable y Cognition utilizan Cerebras para que sus agentes de codificación respondan al instante. Como señala Anton Osika, CEO de Lovable: "Cerebras nos ayuda a hacer que Lovable responda tan rápido como piensan nuestros clientes". Esto permite programar, depurar y refactorizar en tiempo real sin perder el flujo de trabajo.
Agentes de IAAI AgentsSistemas que ejecutan tareas multi-paso sin supervisión constante ininterrumpidos: Para empresas como NinjaTech, la velocidad garantiza que los flujos de trabajo de múltiples pasos se ejecuten sin demoras ni tiempos de espera agotados (timeouts).
Respuestas instantáneas y razonamiento profundo: Plataformas de búsqueda empresarial como AlphaSense y Notion utilizan Cerebras para ofrecer búsquedas profundas y análisis complejos en menos de un segundo.
Interacciones de voz fluidas: Para la IA conversacional (como Tavus o LiveKit), la latencia ultrabaja es vital. Cerebras permite respuestas de voz instantáneas y precisas, haciendo que las interacciones se sientan verdaderamente humanas.
Avances en Salud y Ciencia: En el sector médico, el impacto salva vidas. El Mayo Clinic utiliza Cerebras para analizar datos genómicos rápidamente y encontrar tratamientos adecuados, reduciendo el desgaste físico de los pacientes. Asimismo, GSK y el Argonne National Laboratory aceleran el descubrimiento de fármacos y la predicción de respuestas a medicamentos contra el cáncer, haciendo en meses lo que antes tomaba años.
Validación de Gigantes Tecnológicos: Líderes como OpenAI, Meta y AWS integran soluciones de Cerebras para diversificar su portafolio de cómputo, garantizando inferencia de baja latencia y alto rendimiento a escala global.
Opciones de Despliegue Flexibles
Cerebras entiende que cada empresa tiene requisitos únicos de seguridad y cumplimiento normativo. Por ello, ofrece tres modalidades de despliegue:
Cloud: Sirve modelos abiertos en segundos mediante una clave API en su endpoint público, eligiendo de un catálogo que se actualiza regularmente.
Dedicado: Infraestructura en la nube reservada exclusivamente para las cargas de trabajo de tu empresa, garantizando rendimiento predecible.
On-Premise (Local): Despliegue de la infraestructura física de Cerebras en tus propios centros de datos. Ideal para mantener la IA dentro de tu región, cumpliendo con estrictas obligaciones de residencia de datos y marcos de cumplimiento normativo.
Integración Perfecta con Naios.net
Tener acceso al hardware más rápido del mundo es solo la mitad de la ecuación; la otra mitad es cómo orquestar, gestionar y entregar esa IA a tus usuarios finales o procesos empresariales. Aquí es donde entra en juego naios.net.
Naios.net es una plataforma integral diseñada para facilitar la adopción, gestión y escalabilidad de soluciones de inteligencia artificial en entornos corporativos. La gran noticia es que naios.net es completamente integrable con Cerebras AI.
¿Qué significa esta integración para tu empresa?
Al combinar el poder de procesamiento masivo de Cerebras con la versatilidad de naios.net, las empresas obtienen una solución de IA de extremo a extremo inigualable:
Orquestación Simplificada: Naios.net actúa como el cerebro operativo de tus aplicaciones de IA. Puedes diseñar flujos de trabajo, gestionar prompts y configurar agentes inteligentes desde su interfaz intuitiva, mientras que Cerebras se encarga del cómputo pesado en el backend.
Transición Transparente (Drop-in): Como Cerebras ofrece compatibilidad con la API de OpenAI, conectar naios.net a la infraestructura de Cerebras requiere cambios mínimos en la configuración. Simplemente apuntas los endpoints de naios.net a Cerebras y disfrutas de un aumento de velocidad de hasta 30x.
Agentes de IA en Tiempo Real: Si utilizas naios.net para crear asistentes de voz, copilotos de servicio al cliente o agentes de análisis financiero, la integración con Cerebras garantiza que estos agentes operen sin la latencia típica (lag) que frustra a los usuarios, procesando cientos de tokens por segundo.
Escalabilidad Rentable: Gestiona tus usuarios, cuotas y analíticas en naios.net, mientras te beneficias de la eficiencia de costos (precio-rendimiento) que ofrece la nube de inferencia de Cerebras.
A continuación, se ilustra cómo funciona la arquitectura de esta poderosa integración:
classDef naios fill:#007BFF,stroke:#0056b3,stroke-width:2px,color:#fff;
classDef cerebras fill:#FF4500,stroke:#cc3700,stroke-width:2px,color:#fff;
class B naios;
class C cerebras;
Conclusión
El cuello de botella de la inferencia en la inteligencia artificial ha sido superado. Cerebras AI, con su revolucionario CS-4 y su enfoque de hardware a escala de oblea, ha demostrado que es posible ejecutar modelos de IA de frontera a velocidades que imitan la fluidez del pensamiento humano.
Desde acelerar el descubrimiento de medicamentos hasta permitir la creación de software en tiempo real, Cerebras está empoderando a los desarrolladores para construir lo que antes era imposible. Y al integrar esta potencia de fuego bruta con plataformas de gestión inteligentes como naios.net, cualquier empresa puede ahora desplegar, controlar y escalar aplicaciones de IA de próxima generación con una facilidad, velocidad y rentabilidad sin precedentes. El futuro de la IA ultrarrápida ya está aquí, y es el momento de construir sobre él.