Qu'est-ce que Cerebras AI : La Révolution dans l'Inférence de l'IA et son Intégration avec NAiOS.net*
Dans l'écosystème effréné de l'intelligence artificielle, la vitesse de traitement et la réactivité sont devenues les principaux goulets d'étranglement pour les entreprises. À mesure que les modèles de langage (LLMs) augmentent en taille et en complexité, les infrastructures traditionnelles basées sur des GPU peinent souvent à maintenir une faible latence sans faire exploser les coûts. C'est dans ce contexte que Cerebras AI (https://www.cerebras.ai/) émerge, une entreprise qui redéfinit les limites du matériel pour l'intelligence artificielle.
Dans cet article, nous explorerons en profondeur ce qu'est Cerebras, pourquoi son nouvel accélérateur CS-4 change la donne, comment il impacte diverses industries et, surtout, comment vous pouvez tirer parti de tout ce potentiel grâce à son intégration avec naios.net.
Qu'est-ce que Cerebras AI ?
Cerebras Systems est une entreprise technologique spécialisée dans la création de matériel et de logiciels conçus exclusivement pour accélérer l'intelligence artificielle. Contrairement aux approches traditionnelles qui connectent des milliers de petites puces (GPU) via des réseaux complexes, Cerebras a adopté une approche radicalement différente : le Wafer-Scale Engine (WSE).
Au lieu de découper une plaquette de silicium en centaines de puces individuelles, Cerebras utilise la plaquette entière pour créer un unique processeur géant. Cela élimine les retards de communication entre les puces, permettant un large bande passante et une vitesse de traitement que les architectures conventionnelles ne peuvent tout simplement pas égaler.
Le résultat de cette innovation est une plateforme qui permet d'entraîner, d'ajuster (fine-tune) et de servir des modèles d'IA sur une unique infrastructure, optimisant ainsi tout le cycle de vie de l'apprentissage automatique.
Cerebras CS-4 : L'IA la plus rapide, maintenant encore plus rapide
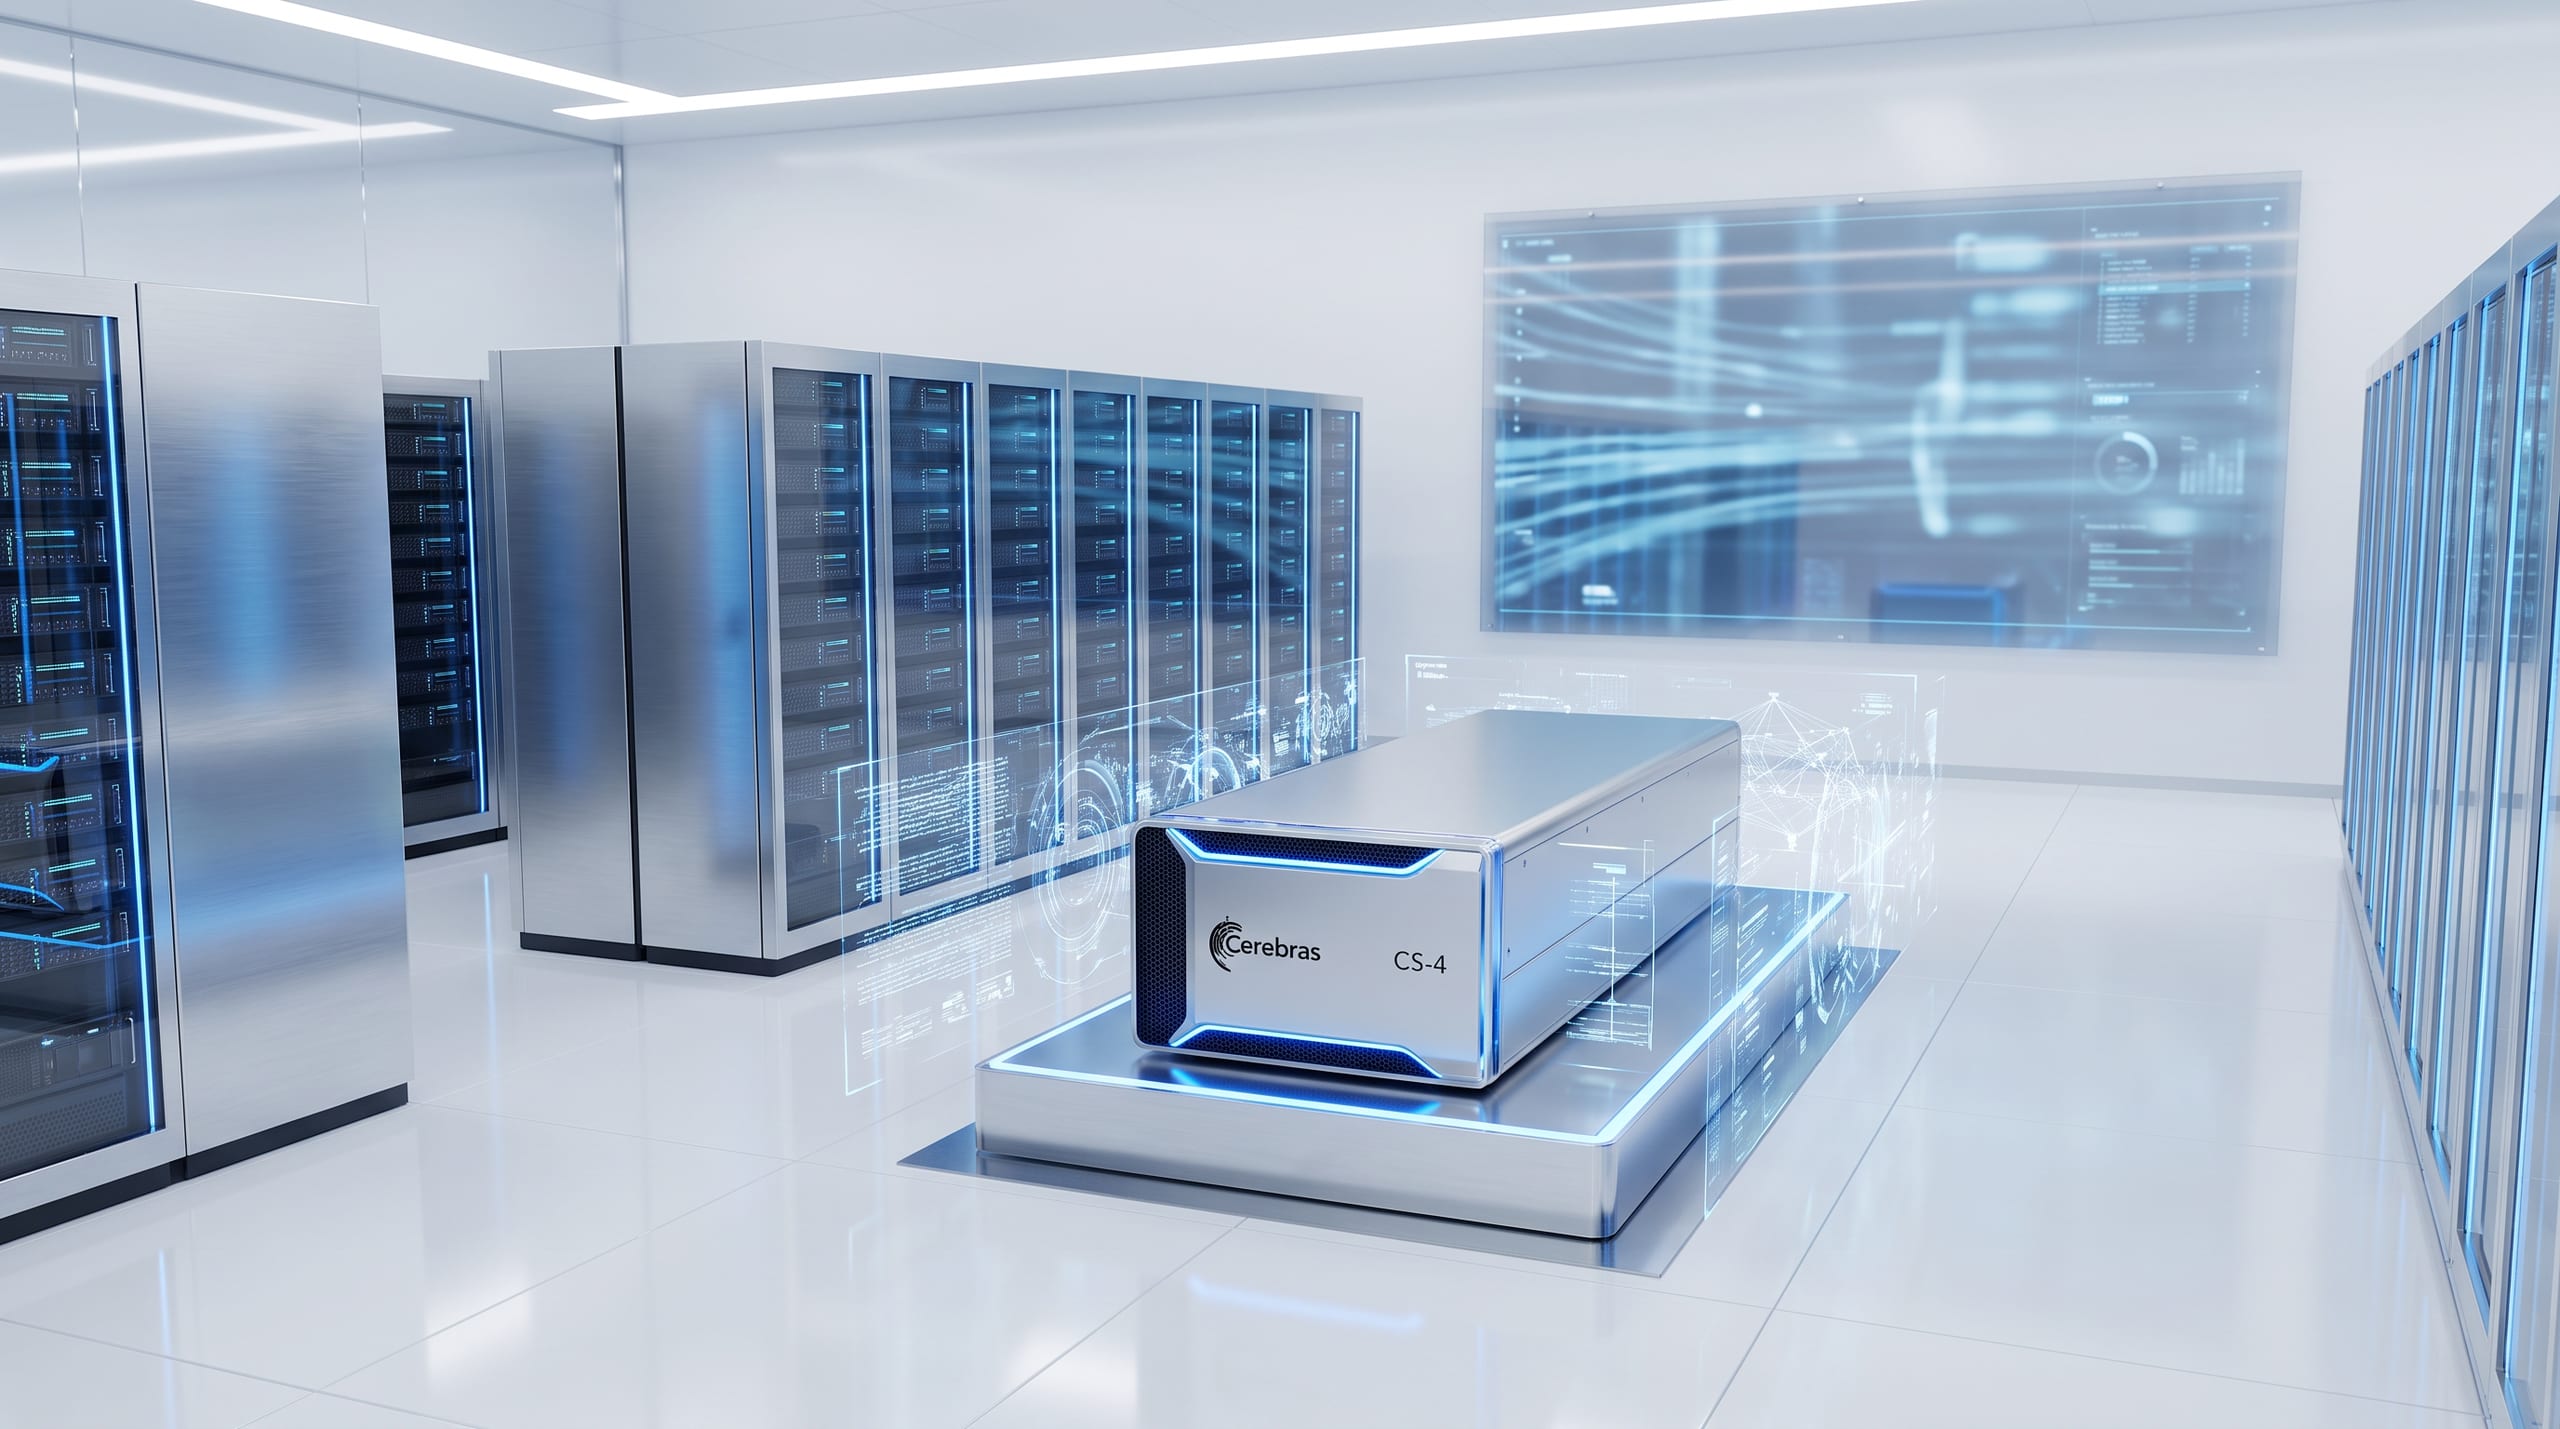
Le produit phare actuel de l'entreprise est le Cerebras CS-4, une solution à l'échelle du rack (rack-scale) qui offre une inférence jusqu'à 30 fois plus rapide par rapport aux GPU traditionnels. Conçu pour des déploiements à hyper-échelle, le CS-4 se positionne comme l'infrastructure la plus rapide au monde pour l'IA de "Frontière" (les modèles d'IA les plus avancés).
Pour mettre cette vitesse en perspective, des modèles de pointeModèles frontièresLes modèles les plus avancés et les plus puissants à tout moment comme le GPT-5.6 Sol Ultrafast d'OpenAI sont disponibles sur la plateforme de Cerebras fonctionnant à des vitesses étonnantes allant jusqu'à 750 tokens par seconde. D'autres modèles leaders qui tirent parti de cette architecture incluent QWEN 3.8 27B, Kimi K2.6 et Codex-Spark.
L'alliance avec AMD pour l'Inférence Désagrégée
Cerebras ne travaille pas de manière isolée. Son partenariat récent avec AMD démontre une approche innovante appelée "inférence désagrégée". Dans cette architecture, les systèmes AMD Helios sont combinés avec le Wafer-Scale Engine de Cerebras. AMD gère le "prefill" (le traitement initial du contexte) avec une haute performance, tandis que Cerebras s'occupe de la génération de tokens à des vitesses ultrarapides. Cette synergie maximise l'efficacité et réduit drastiquement le temps de réponse.
Avantages Concurrentiels de Cerebras
Adopter la technologie de Cerebras offre des bénéfices tangibles qui permettent aux entreprises de construire des produits qui étaient auparavant invivables en raison des limitations de latence :
Vitesse et qualité sans précédent : En disposant d'une inférence plus rapide, les modèles ont un plus grand "budget de latence" pour réaliser des raisonnements complexes (Chain of Thought) sans faire attendre l'utilisateur. Cela se traduit par des réponses de meilleure qualité dans le même temps.
Leadership en Prix-Performance : Cerebras permet de réduire drastiquement les coûts d'infrastructure IA par rapport aux clouds basés sur GPU, tout en atteignant des performances jusqu'à 30 fois supérieures.
Facilité pour les Développeurs : La plateforme est éprouvée à l'échelle de l'entreprise. Les développeurs peuvent commencer à l'utiliser en moins de 30 secondes grâce à sa compatibilité directe (drop-in) avec l'API d'OpenAI.
Cycle complet sur une plateforme : Vous pouvez commencer avec une inférence ultrarapide et, par la suite, effectuer un fine-tuningFine-tuningRéentraîner un modèle avec des données spécifiques pour un cas d'usage ou un préentraînement avec vos propres données pour optimiser les modèles selon vos cas d'utilisation spécifiques.
Cas d'Utilisation et Témoignages de Leaders du Secteur
La vitesse de Cerebras permet de nouveaux paradigmes d'interaction homme-machine. Certaines des entreprises les plus innovantes du monde profitent déjà de cette technologie :
Développement de Logiciel à la vitesse de la pensée : Des entreprises comme Lovable et Cognition utilisent Cerebras pour que leurs agents de codage répondent instantanément. Comme le souligne Anton Osika, PDG de Lovable : "Cerebras nous aide à faire en sorte que Lovable réponde aussi vite que pensent nos clients". Cela permet de programmer, déboguer et refactoriser en temps réel sans perdre le flux de travail.
Agents IA ininterrompus : Pour des entreprises comme NinjaTech, la vitesse garantit que les flux de travail multi-étapes s'exécutent sans retards ni délais d'attente épuisés.
Réponses instantanées et raisonnement approfondi : Des plateformes de recherche d'entreprise comme AlphaSense et Notion utilisent Cerebras pour offrir des recherches approfondies et des analyses complexes en moins d'une seconde.
Interactions vocales fluides : Pour l'IA conversationnelle (comme Tavus ou LiveKit), la latence ultra-basse est vitale. Cerebras permet des réponses vocales instantanées et précises, rendant les interactions véritablement humaines.
Avancées en santé et science : Dans le secteur médical, l'impact sauve des vies. La Mayo Clinic utilise Cerebras pour analyser rapidement des données génomiques et trouver des traitements appropriés, réduisant l'épuisement physique des patients. De même, GSK et le Laboratoire national d'Argonne accélèrent la découverte de médicaments et la prédiction des réponses aux traitements contre le cancer, réalisant en mois ce qui prenait auparavant des années.
Validation des géants technologiques : Des leaders comme OpenAI, Meta et AWS intègrent des solutions de Cerebras pour diversifier leur portefeuille de calcul, garantissant une inférence à faible latence et haute performance à l'échelle mondiale.
Options de déploiement flexibles
Cerebras comprend que chaque entreprise a des exigences uniques en matière de sécurité et de conformité. C'est pourquoi elle propose trois modalités de déploiement :
Cloud : Sert des modèles ouverts en quelques secondes via une clé API sur son point de terminaison public, choisissant dans un catalogue qui est régulièrement mis à jour.
Dédié : Infrastructure cloud réservée exclusivement aux charges de travail de votre entreprise, garantissant des performances prévisibles.
On-Premise (Local) : Déploiement de l'infrastructure physique de Cerebras dans vos propres centres de données. Idéal pour maintenir l'IA dans votre région, en respectant des obligations strictes de résidence des données et des cadres de conformité.
Intégration parfaite avec Naios.net
Avoir accès au matériel le plus rapide du monde n'est que la moitié de l'équation ; l'autre moitié est de savoir comment orchestrer, gérer et livrer cette IA à vos utilisateurs finaux ou processus d'affaires. Voici où entre en jeu naios.net.
Naios.net est une plateforme intégrale conçue pour faciliter l'adoption, la gestion et l'évolutivité des solutions d'intelligence artificielle dans les environnements d'entreprise. La grande nouvelle est que naios.net est entièrement intégrable avec Cerebras AI.
Que signifie cette intégration pour votre entreprise ?
En combinant la puissance de traitement massif de Cerebras avec la polyvalence de naios.net, les entreprises obtiennent une solution d'IA de bout en bout inégalée :
Orchestration Simplifiée : Naios.net agit comme le cerveau opérationnel de vos applications d'IA. Vous pouvez concevoir des flux de travail, gérer des prompts et configurer des agents intelligents depuis son interface intuitive, tandis que Cerebras s'occupe du calcul lourd en arrière-plan.
Transition Transparente (Drop-in) : Comme Cerebras offre une compatibilité avec l'API d'OpenAI, connecter naios.net à l'infrastructure de Cerebras nécessite des changements minimes dans la configuration. Il vous suffit de pointer les endpoints de naios.net vers Cerebras et de profiter d'une augmentation de vitesse allant jusqu'à 30x.
Agents d'IAAgents d'IASystèmes exécutant des tâches multi-étapes sans supervision constante en Temps Réel : Si vous utilisez naios.net pour créer des assistants vocaux, des copilotes de service client ou des agents d'analyse financière, l'intégration avec Cerebras garantit que ces agents fonctionnent sans la latence typique (lag) qui frustre les utilisateurs, traitant des centaines de tokens par seconde.
Scalabilité Rentable : Gérez vos utilisateurs, quotas et analyses sur naios.net, tout en bénéficiant de l'efficacité des coûts (prix-performance) que propose le cloud d'inférence de Cerebras.
Voici comment fonctionne l'architecture de cette puissante intégration :
classDef naios fill:#007BFF,stroke:#0056b3,stroke-width:2px,color:#fff;
classDef cerebras fill:#FF4500,stroke:#cc3700,stroke-width:2px,color:#fff;
class B naios;
class C cerebras;
Conclusion
Le goulot d'étranglement de l'inférence en intelligence artificielle a été surmonté.
Cerebras AI, avec son révolutionnaire CS-4 et son approche matérielle à l'échelle de la plaquette, a prouvé qu'il est possible d'exécuter des modèles d'IA de pointe à des vitesses qui imitent la fluidité de la pensée humaine.De l'accélération de la découverte de médicaments à la création de logiciels en temps réel, Cerebras permet aux développeurs de construire ce qui était auparavant impossible. Et en intégrant cette puissance de feu brute avec des plateformes de gestion intelligentes comme naios.net, toute entreprise peut désormais déployer, contrôler et mettre à l'échelle des applications d'IA de prochaine génération avec une facilité, une rapidité et une rentabilité sans précédent. L'avenir de l'IA ultrarapide est déjà là, et il est temps de construire dessus.